Modelos GPT-6: como escolher entre Astra, Sol, Luna e 6.1 Sol
A família GPT-6 inclui Astra, Sol, Luna e o mais recente GPT-6.1 Sol. Para trabalhos complexos no Codex, ChatGPT Work ou na API, comece avaliando o 6.1 Sol. Para classificação e extração em grande escala, teste o Luna; para raciocínio difícil e entregas profissionais exigentes, considere o Astra. A opção “GPT-6” do chat comum tem outro mapeamento e não significa automaticamente 6.1 Sol.
A OpenAI lançou Astra em 3 de setembro, Sol e Luna em 22 de setembro e 6.1 Sol em 29 de setembro de 2026. Em relação ao GPT-5.6, os avanços mais relevantes envolvem execução de tarefas complexas, confiabilidade e custo. As experiências, porém, divergem: há elogios à capacidade profissional do Astra, críticas à qualidade do código do 6 Sol e reclamações sobre a espera no 6.1 Sol. Histórico oficial de lançamentos
Informações verificadas em 16 de outubro de 2026. Preços em dólares americanos. Avaliações oficiais, testes da comunidade e recomendações editoriais são identificados separadamente.
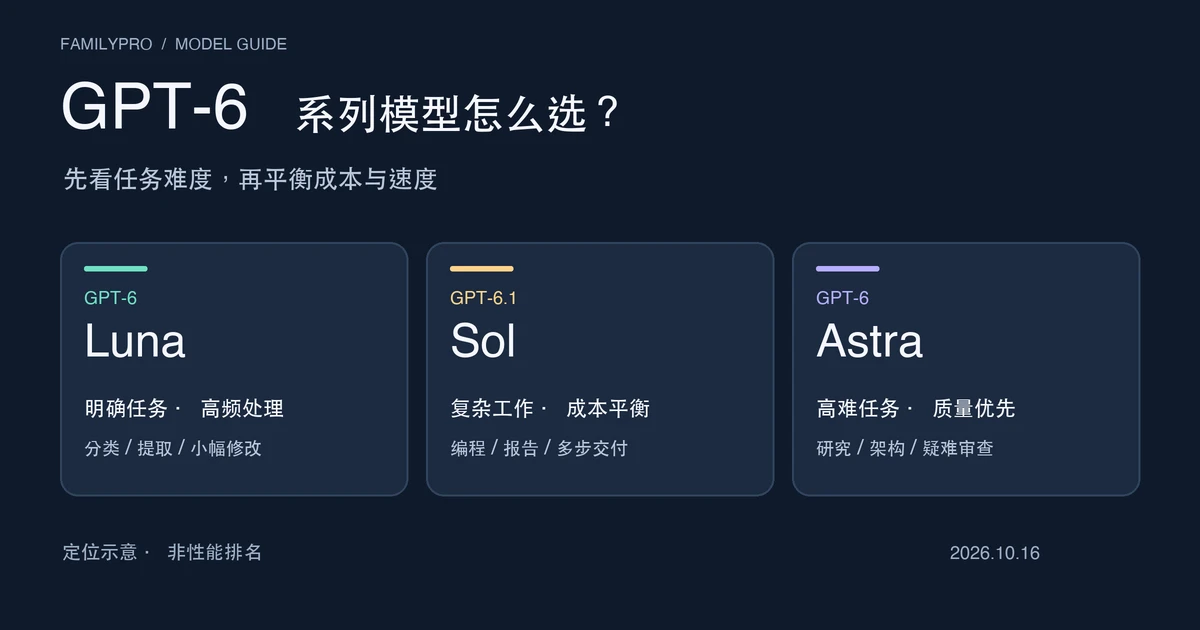
Ilustração editorial do posicionamento dos modelos; não é uma captura do produto nem um resultado de benchmark.
Navegação rápida
- Modelos disponíveis
- Melhorias em relação ao GPT-5.6
- O que é o 6.1 Sol
- Preços da API
- Planos do ChatGPT
- Escolha por tarefa
- Opiniões e testes de velocidade
- Perguntas frequentes
Quais modelos GPT-6 existem?
| Modelo | Posicionamento | Trabalhos indicados |
|---|---|---|
| GPT-6 Astra | Modelo principal, maior capacidade | Raciocínio difícil, pesquisa, programação complexa, entregas profissionais |
| GPT-6 Sol | Primeira opção equilibrada | Programação, ferramentas, fluxos de agentes |
| GPT-6.1 Sol | Opção equilibrada atualizada | Engenharia de software complexa, trabalho profissional, agentes com orçamento limitado |
| GPT-6 Luna | Leve e eficiente | Processamento em lote, classificação, extração, automação frequente |
Astra prioriza a qualidade nos trabalhos mais difíceis; 6.1 Sol busca aproximar essa capacidade com custo menor; Luna prioriza velocidade e economia. O 6 Sol continua disponível na API, mas novos projetos podem avaliar primeiro o 6.1 Sol. A geração 5.6 tinha Sol, Terra e Luna; o catálogo atual da geração 6 não apresenta um Terra oficial correspondente. Catálogo de modelos OpenAI
Astra: capacidade máxima para trabalhos exigentes
Astra foi pensado para grandes repositórios, pesquisa, relatórios empresariais, software profissional e operações prolongadas no computador. O acesso a ferramentas continua dependendo do ambiente, das permissões e da aplicação. Seu preço torna caro usá-lo como padrão em toda solicitação simples.
Sol e 6.1 Sol: o equilíbrio muda
O 6 Sol levou parte das capacidades do modelo principal a um preço menor: suas tarifas normais de entrada e saída são um quinto das do Astra. Alguns usuários antigos do 5.6 Sol, entretanto, relatam menor completude e estabilidade em trabalhos complexos.
O 6.1 Sol chegou uma semana depois, com melhorias em engenharia de software, compreensão de documentos, uso do computador e precisão factual. “Astra Lite” é um apelido da comunidade, não um nome oficial. O anúncio citado não esclarece uma relação arquitetural entre eles e não permite afirmar que 6.1 Sol seja uma versão comprimida do Astra.
Luna: execução econômica em grande escala
Luna é o ponto de partida para classificar chamados, extrair dados estruturados, filtrar informações, fazer edições simples de código e automatizar rotinas. Distinguir um e-mail de reembolso de uma reclamação raramente exige raciocínio matemático de ponta.
GPT-6 versus GPT-5.6: o que melhorou?
Programação e engenharia complexa
Os números abaixo são um retrato do relatório de lançamento do Astra, usando o melhor resultado de cada modelo entre diferentes níveis de raciocínio. Não são comparações com esforço de raciocínio idêntico. Avaliações de pesquisa/API podem diferir do ChatGPT em produção; não reproduzimos os testes. Relatório de lançamento do Astra
| Benchmark | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4.0 | 37.3% | 57.9% |
| DeepSWE v1.1 | 72.7% | 74.1% |
| FrontierCode 1.1 Main (pontuação) | 47.5 | 53.3 |
| Migração de banco de dados (interno) | 42.7% | 63.9% |
O ganho é de 20,6 pontos percentuais no Terminal-Bench, mas apenas 1,4 no DeepSWE. A evolução varia bastante por avaliação; dois resultados não bastam para dividir todas as tarefas de programação em categorias de ganho grande ou pequeno. Compreender o repositório, executar testes e entregar código pronto para integração pode valer mais que gerar código rapidamente.
Uso do computador
OSWorld usa o conjunto offline v2026.08.08; ScreenSpot-Pro usa a configuração sem ferramentas. OSWorld mede operações reais no computador, ScreenSpot a localização visual de elementos e AutomationBench fluxos empresariais entre ferramentas. Relatório de lançamento do Astra
| Benchmark | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| OSWorld 2.0 (offline, pontuação parcial) | 65.7% | 72.6% |
| ScreenSpot-Pro | 76.9% | 92.7% |
| AutomationBench | 18.1% | 41.4% |
Na simulação oficial de latência do OSWorld, o 5.6 Sol leva aproximadamente 75 minutos por tarefa, com 65,7% de pontuação; Astra leva cerca de 40 minutos, com 72,6%. Isso representa aproximadamente 47% menos tempo simulado. Os percentuais incluem crédito parcial e não indicam a proporção de tarefas concluídas perfeitamente. O resultado não garante a mesma aceleração em outros ambientes.
Pesquisa, precisão factual e limites de autorização
No relatório inicial do Astra, Terminal-Bench Science 0.1 passa de 22,4% para 64,6%, e FrontierMath Tier 4 v2 de 83,0% para 97,6%. Relatórios posteriores podem atualizar os números. Bons resultados nesses testes não substituem a verificação independente de métodos, dados, experimentos e conclusões científicas. Relatório de lançamento do Astra
A OpenAI relata aproximadamente metade dos erros factuais do antecessor para o 6 Sol em uma avaliação especialmente difícil. No 6.1 Sol, com raciocínio baixo, as respostas contendo erros caem de 11,4% para 7,7%: redução de 3,7 pontos percentuais, ou cerca de 32% em termos relativos. As amostras vieram de conversas difíceis em que usuários sinalizaram erros; não representam taxas de erro do uso cotidiano. Lançamento de Sol e Luna Avaliação e lançamento do 6.1 Sol
Astra também recebeu treinamento para respeitar melhor o escopo autorizado, reduzindo ações extras sem permissão, relatos enganosos de execução e desvios do objetivo. Um agente com acesso a arquivos, navegador e sistemas externos precisa respeitar os limites da tarefa, além de ter capacidade para executá-la.
Contexto em tarefas longas
Resumos de conversas podem perder detalhes importantes. O anúncio do Astra descreve um mecanismo experimental no Codex para manter notas de trabalho e recuperar informações de janelas anteriores de contexto, buscando reduzir perdas em depuração longa e grandes refatorações. Consulte a documentação atual do cliente sobre disponibilidade e ativação: não é um comportamento padrão garantido em todo ambiente. A família também melhora o cache de prompts, o que pode reduzir custos ao reler código, instruções e documentos empresariais. Relatório de lançamento do Astra Lançamento de Sol e Luna
O que é GPT-6.1 Sol e como difere do 6 Sol?
Capacidade próxima em alguns testes, custo menor
No DeepSWE v1.1, a OpenAI relata que 6.1 Sol supera o melhor resultado do 6 Sol em 6,4 pontos percentuais com menor esforço e custo, além de igualar Astra por aproximadamente um quinto do custo por tarefa. No OSWorld 2.0 offline em Max, fica a até 2,1 pontos do Astra por cerca de um sétimo do custo. São relações de avaliações e configurações específicas, não proporções universais. Astra continua recomendado para os problemas científicos mais difíceis. Avaliação e lançamento do 6.1 Sol
Cache mais barato
As tarifas Standard continuam em US$ 2 por milhão de tokens de entrada e US$ 10 de saída. A leitura de entrada em cache cai de US$ 0,20 no 6 Sol para US$ 0,10 no 6.1 Sol. Uma pergunta isolada pode economizar pouco; agentes que releem repositórios, ferramentas e histórico podem acumular economias. Em algumas tarefas complexas, o uso menor de tokens também reduz a conta.
Custo baixo não garante baixa latência
O objetivo é executar boa parte do trabalho com orçamento sustentável. A velocidade, porém, depende do nível de raciocínio, do modo de serviço e da carga; alguns desenvolvedores relatam lentidão frente ao 5.6 Sol. Avalie execução em segundo plano para trabalhos longos e meça separadamente a latência de usos interativos.
6.1 Sol não aceita none nem minimal: o mínimo é low. Compare Luna, que aceita none, em tarefas simples. Chamadas de ferramentas com 6.1 Sol exigem a Responses API; trocar apenas o identificador do modelo em uma aplicação antiga não completa a migração. Documentação API do 6.1 Sol
Preços da API GPT-6 e cálculo de custos
Tarifas Standard de texto, em dólares por milhão de tokens, para solicitações com até 272K tokens de entrada:
| Modelo | Entrada | Entrada em cache | Saída |
|---|---|---|---|
| GPT-5.6 Sol | $4.00 | $0.40 | $20.00 |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 |
| GPT-6 Sol | $2.00 | $0.20 | $10.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
Astra custa 2,5 vezes o 5.6 Sol em entrada/saída padrão. As duas versões 6 Sol custam metade do 5.6 Sol. Com igual volume de entrada sem cache e saída, Luna custa um centésimo de Astra. A tarifa do 5.6 Sol é promocional, prevista pelo menos até 21 de novembro de 2026; verifique novamente depois. Tarifas do 5.6 Sol
Exemplo mensal
Considere 1.000 solicitações por mês, cada uma com 2.000 tokens de entrada e 500 tokens de saída faturados, incluindo raciocínio. São 2 milhões de entrada e 0,5 milhão de saída. Sem cache, ferramentas, repetições ou adicionais:
| Modelo | Custo mensal teórico da API |
|---|---|
| GPT-6 Astra | $45.00 |
| GPT-6.1 Sol | $9.00 |
| GPT-6 Luna | $0.45 |
Para 6.1 Sol: 2 × US$ 2 + 0,5 × US$ 10 = US$ 9. É um exemplo de volume fixo, não uma média medida. Se os 500 tokens forem apenas a resposta visível, some o raciocínio interno, cobrado como saída. Cobrança de tokens de raciocínio
Luna pode bastar para categorias de chamados, números de pedido e JSON. Em disputas contratuais, análise de evidências ou decisões em várias etapas, modelos mais fortes podem reduzir a correção humana. Compare custo por tarefa concluída com sucesso, além do preço unitário.
Regras que alteram a conta
- Os principais modelos oferecem cerca de 1,05 milhão de tokens de contexto e até 128K de saída; o 5.6 Sol já tinha essa capacidade.
- Acima de 272K tokens de entrada, a tarifa de contexto longo vale para toda a solicitação: entrada e tarifas relacionadas a cache dobram; saída custa 1,5 vez o padrão.
- Leitura e gravação de cache são diferentes: 6.1 Sol lê por US$ 0,10 e grava por US$ 2,50 por milhão de tokens na modalidade Standard.
- Batch/Flex geralmente custam 50% menos que Standard, com contrapartidas de fila, vazão ou latência. Fast geralmente custa o dobro; Ultrafast do 6.1 Sol na API custa seis vezes Standard. A disponibilidade varia por modelo e os multiplicadores de preço não garantem aceleração equivalente. Processamento regional compatível pode acrescentar 10%.
Preços dos planos ChatGPT e acesso aos modelos
A assinatura fornece uso conforme plano e limites; a API tem cobrança separada. Plus não inclui US$ 20 em crédito de API. Estes são preços mensais oficiais em dólares, sujeitos a região, impostos e checkout. Chat comum e Work/Codex possuem permissões diferentes.
| Plano | Mensalidade | Acesso relacionado a GPT-6 |
|---|---|---|
| Free | Grátis | Chat migra gradualmente para 5.6 Luna; 6 Luna tem distribuição separada no Codex desktop |
| Go | $8 na página oficial em dólares; confira preços locais | Chat com 5.6 Luna; distribuição separada de 6 Luna no Codex desktop |
| Plus | $20 | Chat com 6 Sol; Astra e 6.1 Sol, entre outros, em Work/Codex |
| Pro 100 | $100 | GPT-6 Pro e maior limite de trabalho |
| Pro 200 | $200 | Mais uso de GPT-6 Pro, Work e Codex |
| Pro 500 | $500 | Maior faixa de uso, incluindo acesso ao Ultrafast |
Free/Go no Codex desktop dependem da distribuição gradual do 6 Luna; o Chat comum usa 5.6 Luna. Empresas e instituições de ensino têm regras próprias. Modelos no ChatGPT Preços de Work e Codex Níveis do ChatGPT Pro
Qual modelo está por trás de “GPT-6” no Chat?
| Nível de pensamento | Modelo |
|---|---|
| Instant | GPT-6 Sol |
| Medium | GPT-6 Sol |
| High | GPT-6 Sol |
| Extra High | GPT-6 Sol |
| Pro | GPT-6 Pro baseado em GPT-6 Astra |
Plus normalmente oferece Instant, Medium e High, sem Extra High e Pro no Chat. Planos superiores oferecem níveis adicionais conforme a conta. 6.1 Sol não é atualmente uma opção separada no Chat comum; é oferecido em Work, Codex e API. Não aparecer no Chat não determina sua disponibilidade nas demais interfaces. GPT-6 Pro tem limite próprio: uma assinatura Pro não implica Astra ilimitado.
No Pro 500, Ultrafast consome o limite incluído a oito vezes a taxa padrão do modelo. Após esse limite, Credits comprados são cobrados a seis vezes a taxa padrão de Credits. Antes de subir de plano, defina se precisa de volume, capacidade ou menor latência. Veja limites e reinicializações do Codex (em inglês) e ChatGPT Go versus Plus (em inglês). Modelos no ChatGPT Níveis do ChatGPT Pro
Como escolher GPT-6 por tarefa?
São pontos de partida baseados no guia oficial, não configurações com resultado garantido. Chat comum usa seus níveis visíveis; Work/Codex e API têm conjuntos próprios de opções. Guia oficial de seleção
| Tarefa | Modelo inicial | Raciocínio |
|---|---|---|
| Classificação, etiquetas, extração | GPT-6 Luna | None / Low |
| Atendimento frequente, texto simples | GPT-6 Luna | Low / Medium |
| Conversas cotidianas no ChatGPT | GPT-6 Sol | Instant |
| Artigos longos, análise e planejamento | GPT-6 Sol | Medium / High |
| Programação e correção de bugs | GPT-6.1 Sol | Medium |
| Refatoração entre arquivos, revisão complexa | GPT-6.1 Sol | High / XHigh |
| Grandes projetos, operações complexas no computador | GPT-6 Astra | Comece em Medium; High / Max se necessário |
| Pesquisa difícil, raciocínio especializado | GPT-6 Astra | Compare Medium com High / Max |
| Automação periódica em lote | Luna; escale para Sol se necessário | Low / Medium |
Maior raciocínio pode aumentar verificação, tokens e tempo sem melhorar tarefas simples de limites claros.
Encaminhe tarefas conforme a complexidade
Comece rotinas no Luna. Envie falhas em validações, informações conflitantes ou tarefas conhecidamente multietapas ao 6.1 Sol. Use regras de negócio, validação de saída e amostragem, sem depender da confiança declarada pelo modelo. Reserve Astra para casos difíceis e falhas caras. Um atendimento pode classificar com Luna, analisar disputas com Sol e usar Astra como apoio nos casos de maior risco, com decisão humana final.
Meça o custo completo
Custo por tarefa = chamadas do modelo + ferramentas + novas tentativas + correção humana. Um modelo barato que precisa de cinco tentativas pode custar mais que Astra concluindo de primeira. Em programação, inclua aprovação dos testes, possibilidade de integrar o código, tamanho da mudança e tempo de revisão.
Aproveite execução assíncrona e cache
Varreduras de repositórios, relatórios semanais, organização de documentos e análises longas podem rodar em segundo plano no 6.1 Sol. Paralelizar tarefas independentes reduz a espera humana, mas não reduz automaticamente a conta. Produtos interativos podem se beneficiar mais de Luna, menor raciocínio ou serviço mais rápido.
Mantenha prompts de sistema, definições de ferramentas e instruções do repositório em prefixos estáveis. Confira acertos de cache no uso real: repetir conteúdo não significa que tudo será cobrado como cache. Remova contexto antigo ou irrelevante; cache não substitui essa gestão.
Opiniões da comunidade: código, custo e velocidade
Os exemplos rastreáveis do Reddit e Hacker News não são amostra aleatória nem representam toda a opinião pública. Há elogios à capacidade do Astra com críticas ao consumo, preferência pelo 5.6 em alguns fluxos e aceitação da espera do 6.1 em troca de economia.
Astra: competência profissional e limites práticos
imadade, no Reddit, descreveu problemas empresariais e teóricos que antes exigiam orientação repetida, agora resolvidos com comunicação concisa e perguntas extras principalmente quando necessárias. Reddit: primeiras experiências com Astra
No Hacker News, um usuário comparou prompts idênticos com 5.6 Sol e encontrou mais fontes relevantes e melhores materiais de estudo no Astra. Outro elogiou síntese e linguagem natural, mas criticou preço e consumo rápido do limite. Um relato de automação desktop descreveu interrupções repetidas, exigindo pedir para continuar. Ferramentas, planejamento, prompts e limites afetam o resultado. Hacker News: primeiras opiniões sobre Astra
6 Sol: por que alguns preferem 5.6?
Jarr11, no r/OpenAI, considerou 6 Sol menos completo e detalhado em trabalhos complexos, enquanto Astra parecia caro demais. Alguns comentaristas voltaram ao 5.6 Sol. São experiências de fluxos específicos, não uma comparação controlada geral; raciocínio, ferramentas e ambientes podem diferir. Ganhos oficiais não garantem melhora igual em todo fluxo existente. Reddit: 6 Sol e 5.6 Sol
6.1 Sol em 24 tarefas reais de código
bisonbear2 converteu 24 alterações já integradas de um repositório Go/TypeScript em tarefas, executando cada modelo uma vez por tarefa em Medium:
| Comparação com GPT-6 Sol | GPT-6.1 Sol |
|---|---|
| Vitórias | 9 |
| Empates | 10 |
| Derrotas | 5 |
6.1 Sol teve pequena vantagem na pontuação geral e custo típico próximo da metade, com cache mais barato e menos tokens. Produziu alterações maiores, potencialmente exigindo mais revisão; não houve diferença relevante de tempo. As cinco derrotas são comparações relativas, não cinco tarefas reprovadas, e não permitem calcular sucesso. É um único repositório, uma execução por modelo/tarefa, com juiz de modelo na avaliação; o autor também desenvolve a ferramenta Stet. Não generalize para toda programação. Reddit: comparação de 24 tarefas de código
Um teste de velocidade da comunidade
Hot_Season8992 mediu todos os modelos em XHigh. Valores em tokens de saída por segundo:
| Modelo | Normal | Fast |
|---|---|---|
| GPT-5.6 Sol | 102.6 | 168.1 |
| GPT-6 Sol | 77.0 | 117.4 |
| GPT-6 Astra | 44.4 | 65.4 |
| GPT-6.1 Sol | 22.3 | 64.2 |
| GPT-6 Luna | 184.7 | 188.5 |
Nesse teste, 6.1 Sol Normal gerou a aproximadamente um quinto da velocidade do 5.6 Sol. Fast acelerou bastante o próprio 6.1, mas ficou abaixo do 5.6 Fast. São medições de um usuário em determinado momento/configuração, sem garantia oficial; conta, carga e solicitação alteram resultados. Reddit: medição de velocidade do 6.1 Sol
Tokens por segundo também não são tempo total: menos ferramentas e repetições podem compensar geração lenta. conception, no Hacker News, considerou a espera cara demais e sugeriu modelos rápidos para parte do trabalho; outro desenvolvedor achou aceitável usar menos raciocínio. Hacker News: debate sobre latência
A qualidade continua dividindo opiniões
Upper-Animator-5067 descreveu um jogo de selva feito em Medium com um fluxo de desenvolvimento indicado: faltavam recursos importantes e o jogo continuou sem funcionar adequadamente após pedidos de correção. Reddit: teste de desenvolvimento de jogo Impossible-Sand5012, por outro lado, relatou trabalhos paralelos confiáveis em Max e baixo consumo do limite, sem registros completos para comparação independente. Reddit: experiência positiva com tarefas longas
Manter um grande repositório, criar um jogo jogável e programar interativamente exigem critérios diferentes. Os relatos sugerem quatro cuidados: pesar a qualidade do Astra contra seu consumo; manter 5.6 como referência quando 6 Sol decepciona; avaliar custo e latência do 6.1 separadamente; e reconhecer o viés de quem publica experiências muito boas ou ruins. Muitos testes não controlam versão, raciocínio, carga ou ferramentas. Discussões ajudam a encontrar problemas, mas não substituem seus próprios testes.
Como avaliar GPT-6 no seu trabalho
Selecione 30 a 50 tarefas recentes, fáceis, médias e difíceis. É uma sugestão inicial prática, sem garantia de representatividade estatística. Compare Luna, 6.1 Sol e Astra com os mesmos dados, instruções e permissões.
Registre sucesso real, custo completo incluindo cache/ferramentas/repetições, tempo até um resultado utilizável e intervenção humana. Para programação complexa, comece com 6.1 Sol Medium e compare Low e High. Teste Luna primeiro em funções frequentes e padronizadas; acrescente Astra quando a qualidade medida justificar. Assim, a decisão considera qualidade, velocidade e orçamento.
GPT-6: perguntas frequentes (FAQ)
Qual modelo GPT-6 é mais potente?
A OpenAI posiciona Astra para o trabalho mais difícil. Escolha pela taxa de sucesso, custo total e tempo: avalie 6.1 Sol em programação complexa cotidiana e Luna em classificação ou extração.
GPT-6.1 Sol é mais barato que GPT-6 Sol?
Ambos custam US$ 2 de entrada e US$ 10 de saída por milhão de tokens em Standard. A leitura em cache cai de US$ 0,20 para US$ 0,10. A conta depende de raciocínio, cache, ferramentas e retrabalho; não custa sempre metade.
ChatGPT Plus permite usar GPT-6.1 Sol?
A documentação oficial o lista para Plus em Work e Codex. O Chat comum possui outro mapeamento GPT-6. Distribuição gradual, versão do cliente e acesso da conta ainda influenciam.
GPT-6.1 Sol é sempre mais lento que 5.6 Sol?
O teste da comunidade citado não permite essa conclusão universal. Compare o tempo completo de tarefas equivalentes, com o mesmo raciocínio e modo de serviço, além dos tokens por segundo.
É necessário migrar todos os fluxos GPT-5.6?
Mantenha 5.6 como referência e compare as mesmas tarefas. Migre quando qualidade, custo ou espera melhorarem o suficiente; uma aplicação pode dividir trabalho entre Luna, Sol e Astra.
Referências
- Histórico oficial de lançamentos
- Catálogo de modelos OpenAI
- Relatório de lançamento do Astra
- Avaliação e lançamento do 6.1 Sol
- Lançamento de Sol e Luna
- Documentação API do 6.1 Sol
- Tarifas do 5.6 Sol
- Cobrança de tokens de raciocínio
- Preços da API OpenAI
- Modelos no ChatGPT
- Preços de Work e Codex
- Níveis do ChatGPT Pro
- Guia oficial de seleção
- Reddit: primeiras experiências com Astra
- Hacker News: primeiras opiniões sobre Astra
- Reddit: 6 Sol e 5.6 Sol
- Reddit: comparação de 24 tarefas de código
- Reddit: medição de velocidade do 6.1 Sol
- Hacker News: debate sobre latência
- Reddit: teste de desenvolvimento de jogo
- Reddit: experiência positiva com tarefas longas
Dados oficiais e preços verificados em 16 de outubro de 2026. Os números da comunidade foram relatados pelos autores originais e não foram reproduzidos independentemente aqui.