GPT-6 im Vergleich: Astra, Sol, Luna und 6.1 Sol richtig auswählen
Zur GPT-6-Familie gehören Astra, Sol, Luna und das neuere GPT-6.1 Sol. Für komplexe Aufgaben in Codex, ChatGPT Work oder der API lohnt sich zunächst ein Test von 6.1 Sol. Für Klassifikation und Datenextraktion in großen Mengen bietet sich Luna an; für besonders anspruchsvolle Forschung, Schlussfolgerungen und professionelle Ergebnisse Astra. „GPT-6“ im gewöhnlichen ChatGPT-Chat hat eine eigene Modellzuordnung und ist nicht automatisch 6.1 Sol.
OpenAI veröffentlichte Astra am 3. September 2026, Sol und Luna am 22. September und 6.1 Sol am 29. September. Die Modelle decken unterschiedliche Aufgaben und Budgets ab. offizielle Veröffentlichungszeitachse
Gegenüber GPT-5.6 stehen die Ausführung komplexer Aufgaben, Erfolgsquoten und Kosten im Mittelpunkt. Die Erfahrungen gehen auseinander: Einige Nutzer loben Astras professionelle Fähigkeiten, andere kritisieren die Codequalität von 6 Sol. Bei 6.1 Sol stehen niedrigeren Kosten teilweise längere Wartezeiten gegenüber. Offizielle Benchmarks, Kostenbeispiele und nachvollziehbare Community-Berichte helfen, diese Unterschiede einzuordnen.
Stand der Quellenprüfung: 16. Oktober 2026. Alle Preise in US-Dollar. Offizielle Ergebnisse, Community-Tests und Empfehlungen werden getrennt gekennzeichnet.
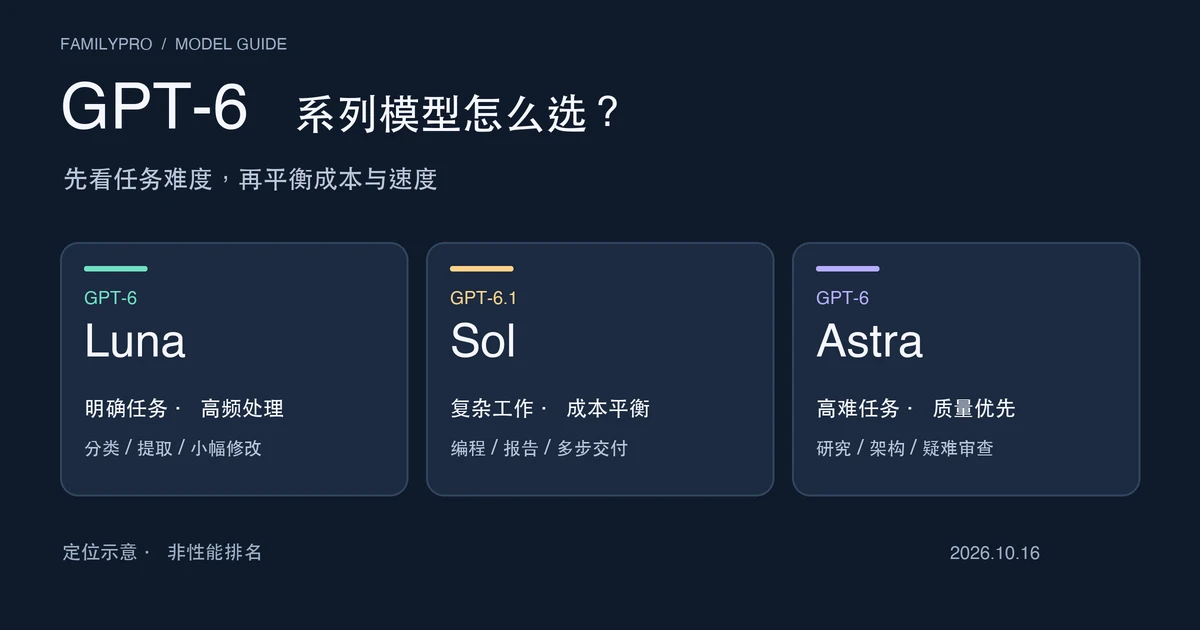
Redaktionelle Darstellung der Modellpositionierung, keine Produktoberfläche und kein Benchmark.
Schnellnavigation
- Welche GPT-6-Modelle gibt es?
- Verbesserungen gegenüber GPT-5.6
- 6.1 Sol gegenüber 6 Sol
- API-Preise und Kostenbeispiele
- ChatGPT-Tarife und Modellzugang
- Modell nach Aufgabe auswählen
- Community-Erfahrungen und Geschwindigkeit
- FAQ
Welche Modelle gehören zur GPT-6-Serie?
Es gibt vier unterscheidbare Modelle; Sol liegt in den Versionen 6 und 6.1 vor.
| Modell | Positionierung | Besonders geeignete Aufgaben |
|---|---|---|
| GPT-6 Astra | Leistungsstärkstes Flaggschiff | Anspruchsvolle Schlussfolgerungen, Forschung, komplexe Programmierung und professionelle Arbeitsergebnisse |
| GPT-6 Sol | Ursprüngliches ausgewogenes Modell | Programmierung, Tool-Aufrufe und Agenten-Workflows |
| GPT-6.1 Sol | Überarbeitetes ausgewogenes Modell | Komplexe Programmierung, professionelle Alltagsarbeit und kostenbewusste Agenten |
| GPT-6 Luna | Schlankes, effizientes Modell | Massenverarbeitung, Klassifikation, Extraktion und häufige Automatisierungen |
Astra priorisiert die Ergebnisqualität. 6.1 Sol soll sich Astras Fähigkeiten bei deutlich geringeren Kosten annähern. Luna legt den Schwerpunkt auf Tempo und geringe Kosten. GPT-6 Sol bleibt über die API verfügbar; für neue Projekte ist 6.1 Sol meist der sinnvollere erste Vergleichskandidat.
Die GPT-5.6-Serie bestand aus Sol, Terra und Luna. Ein entsprechendes offizielles GPT-6 Terra gibt es derzeit nicht. 6.1 Sol übernimmt praktisch die mittlere Position der neuen Generation. OpenAI-Modellverzeichnis
GPT-6 Astra: das Flaggschiff
OpenAI positioniert Astra als sein derzeit stärkstes allgemeines Modell für tiefes Schlussfolgern und hochwertige Ergebnisse. Beispiele sind die Analyse großer Codebasen, komplexe Geschäftsberichte, Arbeit in professioneller Software, wissenschaftliche Fragen und lange Abläufe mit mehreren Computeraktionen.
Im Vordergrund stehen Tool-Nutzung über längere Abläufe und vollständig ausgeführte Aufgaben. Die Ergebnisse hängen weiter von den Werkzeugen und Berechtigungen der Anwendung ab. Die deutlich höheren Kosten machen Astra nicht für jeden Einsatz wirtschaftlich.
GPT-6 Sol: die ursprüngliche ausgewogene Variante
Sol bringt einen Teil der Flaggschiff-Fähigkeiten in eine günstigere Preisklasse, insbesondere für Programmierung, professionelle Arbeit und Agenten. Die Standardpreise für API-Ein- und -Ausgaben betragen jeweils ein Fünftel der Astra-Preise.
Die Reaktionen sind allerdings gemischt. Einige langjährige Nutzer von GPT-5.6 Sol berichten trotz des niedrigeren Preises von Rückschritten bei Vollständigkeit und zuverlässiger Ausführung komplexer Aufgaben.
GPT-6.1 Sol: komplexe Aufgaben zu geringeren Kosten
6.1 Sol erschien eine Woche nach 6 Sol. OpenAI will damit komplexe Aufgaben zu einem Bruchteil der Astra-Kosten auf einem ähnlichen Niveau bearbeiten. Schwerpunkte sind Softwareentwicklung, Dokumentverständnis, Computerbedienung und faktische Genauigkeit.
Die Community nennt es gelegentlich „Astra Lite“. Das ist kein offizieller Modellname. Die hier zitierten offiziellen Beschreibungen erklären die Architekturbeziehung nicht; daraus lässt sich keine komprimierte Astra-Version ableiten.
GPT-6 Luna: günstige Ausführung klarer Aufgaben
Luna ist das günstigste und am stärksten auf schnelle Verarbeitung ausgerichtete GPT-6-Modell. Typische Aufgaben sind Support-Tickets klassifizieren, strukturierte Daten extrahieren, einfache Codeänderungen, Informationen filtern und Routineabläufe automatisieren.
Um eine E-Mail als Rückerstattung oder Beschwerde einzuordnen, ist meist keine Spitzenleistung in mathematischem Denken nötig. Solche häufigen, klar umrissenen Aufgaben sind Lunas Kerngebiet.
GPT-6 gegenüber GPT-5.6: Was verbessert sich?
Die offiziellen Daten zeigen besonders starke Fortschritte bei komplexer Arbeit und Tool-Ausführung. Nicht jede Aufgabe verbessert sich im gleichen Maß.
1. Programmierung: große Unterschiede zwischen Benchmarks
Die folgenden Werte stammen aus dem Astra-Veröffentlichungsbericht. Es handelt sich um den damaligen Teststand und die besten Ergebnisse bei unterschiedlichen Denkintensitäten, nicht um einen Vergleich bei identischer Einstellung. Getestet wurde in Forschungsumgebungen oder per API; die produktive ChatGPT-Version kann abweichen. Wir haben die Tests nicht selbst wiederholt.
| Benchmark | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4.0 | 37.3% | 57.9% |
| DeepSWE v1.1 | 72.7% | 74.1% |
| FrontierCode 1.1 Main (Punktzahl) | 47.5 | 53.3 |
| Datenbankmigrationen (intern) | 42.7% | 63.9% |
Astra gewinnt im Terminal-Bench 20,6 Prozentpunkte, in DeepSWE dagegen nur 1,4. GPT-6 ist also nicht bei sämtlichen Programmieraufgaben wesentlich stärker als 5.6. Die Unterschiede sprechen dafür, komplexe Terminal-Aufgaben gezielt zu testen. Zwei Ergebnisse reichen aber nicht aus, um alle Programmieraufgaben pauschal in große und kleine Fortschritte einzuteilen.
Für Entwickler kann es wichtiger sein, ob ein Modell das Repository versteht, Tests ausführt und integrierbaren Code liefert, als wie schnell es Text erzeugt.
2. Computer Use: vom Antworten zur Computerbedienung
Die Computerbedienung ist ein zentraler Fortschritt. Die folgende Tabelle verwendet ebenfalls die Bedingungen des Astra-Veröffentlichungsbericht: OSWorld mit dem Offline-Datensatz v2026.08.08 und ScreenSpot-Pro ohne Tools.
| Benchmark | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| OSWorld 2.0 (offline, Teilbewertung) | 65.7% | 72.6% |
| ScreenSpot-Pro | 76.9% | 92.7% |
| AutomationBench | 18.1% | 41.4% |
OSWorld untersucht reale Computeraufgaben, ScreenSpot-Pro das Auffinden visueller Oberflächenelemente und AutomationBench vor allem Geschäftsabläufe über mehrere Werkzeuge hinweg.
In der offiziellen OSWorld-Latenzsimulation benötigte GPT-5.6 Sol etwa 75 Minuten pro Aufgabe bei 65,7% Bewertung, Astra etwa 40 Minuten bei 72,6%. Die Bewertung vergibt Teilpunkte; die Prozentwerte sind keine Quote vollständig gelöster Aufgaben. Die simulierte Dauer sinkt damit um ungefähr 47%, während die Bewertung steigt. Das ist ein Ergebnis dieser Testumgebung, keine allgemeine Beschleunigungsgarantie.
3. Forschung: anspruchsvollere Schlussfolgerungen
Im Terminal-Bench Science 0.1 steigt die Bewertung von 22,4% bei 5.6 Sol auf 64,6% bei Astra. Im FrontierMath Tier 4 (v2) stehen 83,0% und 97,6% gegenüber.
Auch diese Zahlen stammen aus dem Astra-Veröffentlichungsbericht; spätere Berichte können aktualisierte Ergebnisse enthalten. Sie belegen Fortschritte in diesen Tests, erlauben aber keine Hochrechnung auf sämtliche Forschung. Hohe Benchmark-Ergebnisse ersetzen keine unabhängige Prüfung wissenschaftlicher Methoden, Daten, Experimente und Schlussfolgerungen.
4. Faktische Genauigkeit und sichere Ausführung
Laut OpenAI macht 6 Sol in einem eigens zusammengestellten schwierigen Faktizitätstest ungefähr halb so viele faktische Fehler wie die vorherige Generation. 6.1 Sol verbessert sich nochmals: Bei geringer Denkintensität sinkt der Anteil fehlerhaltiger Antworten von 11,4% auf 7,7%.
Das sind 3,7 Prozentpunkte beziehungsweise etwa 32% relativ. Die schwierigen Beispiele stammen aus Gesprächen, in denen Nutzer zuvor Fehler markiert hatten. Beide Veröffentlichungen betonen, dass dies keine Fehlerquote des Alltagsgebrauchs ist. Bewertung von 6.1 Sol
Astra wurde außerdem gezielt darauf trainiert, Berechtigungsgrenzen einzuhalten und in komplexen Agentenabläufen unerlaubte Zusatzaktionen, irreführende Ausführungsberichte und Abweichungen vom Ziel zu reduzieren. Modelle mit Zugriff auf Dateien, Browser und externe Systeme müssen auch erkennen, welche Aktionen sie nicht eigenmächtig ausführen dürfen.
5. Kontextverwaltung bei langen Aufgaben
Für Astra in Codex stellte OpenAI experimentelle Mechanismen zur Kontextbewahrung vor. Gewöhnliche Zusammenfassungen langer Gespräche können wichtige Details verlieren. Der beschriebene Ansatz erlaubt Arbeitsnotizen und das Abrufen früherer Kontextfenster, um etwa bei langen Fehlersuchen oder großen Refactorings weniger Informationen zu verlieren.
Ob und wie diese Funktion verfügbar ist, steht in der aktuellen Client-Dokumentation. Der Einführungsbericht bedeutet nicht, dass sie überall standardmäßig aktiv ist. Die GPT-6-Serie verbessert auch das Prompt-Caching. Agenten, die dieselbe Codebasis, Geschäftsdokumente oder Systemanweisungen wiederholt lesen, können dadurch Kosten sparen. Astra-Veröffentlichungsbericht · Veröffentlichung von Sol und Luna
Was ist GPT-6.1 Sol, und was unterscheidet es von 6 Sol?
Astra repräsentiert die Leistungsspitze, 6.1 Sol eine neue Optimierung der Kosteneffizienz.
Vergleichbare Teilergebnisse bei einem Fünftel des Standardpreises
Bei einigen Software-, Dokument- und Computeraufgaben erreicht 6.1 Sol Astra-ähnliche Ergebnisse zu geringeren Aufgabenkosten. In DeepSWE v1.1 liegt es laut OpenAI bei geringerer Denkintensität und niedrigeren Kosten 6,4 Prozentpunkte über dem besten Ergebnis von 6 Sol. Ein Astra vergleichbares Ergebnis erzielt es für etwa ein Fünftel der Aufgabenkosten.
Im Offline-OSWorld-2.0-Test mit maximaler Denkintensität (Max) liegt der Abstand zu Astra innerhalb von 2,1 Prozentpunkten, bei rund einem Siebtel der Kosten je Aufgabe. „Nahe an Astra“ gilt damit für bestimmte Tests und Einstellungen, nicht pauschal. Für die schwierigste Forschung empfiehlt OpenAI weiterhin Astra. Bewertung von 6.1 Sol
Cache-Lesen kostet halb so viel wie bei 6 Sol
Die Standardpreise bleiben gleich: $2 je Million Eingabe-Token und $10 je Million Ausgabe-Token. Der Unterschied liegt beim Cache-Lesen: von $0.20 bei 6 Sol auf $0.10 je Million Token bei 6.1 Sol.
Bei einer einmaligen Frage fällt das kaum ins Gewicht. Programmieragenten lesen jedoch oft wiederholt Repository-Inhalte, Tool-Definitionen und Arbeitsverläufe. Cache-Treffer können die Ersparnis summieren. Verbraucht 6.1 Sol bei bestimmten komplexen Aufgaben zusätzlich weniger Token, können die tatsächlichen Aufgabenkosten deutlich sinken.
Niedrige Kosten bedeuten keine niedrige Latenz
Entwickler benötigen oft ein Modell, das die meisten Aufgaben zuverlässig löst und bei längerem Betrieb bezahlbar bleibt. Genau darauf zielt 6.1 Sol. Günstiger heißt allerdings nicht schneller. Geschwindigkeit hängt von Dienstmodus, Denkintensität und Auslastung ab; einige Entwickler erleben es deutlich langsamer als 5.6 Sol.
Bestätigen eigene Tests lange Wartezeiten, eignen sich komplexe Hintergrundaufgaben. Für interaktive Abläufe sollte die Latenz separat gemessen werden. 6.1 Sol unterstützt weder none noch minimal; die niedrigste Denkintensität ist low. Für einfache Aufgaben lohnt ein Vergleich mit Luna, das none unterstützt. Bei Tool-Aufrufen benötigt 6.1 Sol die Responses API: Nur die Modell-ID einer alten Anwendung auszutauschen genügt nicht für eine Migration. 6.1-Sol-API-Dokumentation
GPT-6-API-Preise und Kostenberechnung
Die folgenden offiziellen Standardpreise gelten in US-Dollar je Million Token für gewöhnliche Textanfragen bis 272K Eingabe-Token.
| Modell | Eingabe | Cache-Eingabe | Ausgabe |
|---|---|---|---|
| GPT-5.6 Sol | $4.00 | $0.40 | $20.00 |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 |
| GPT-6 Sol | $2.00 | $0.20 | $10.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
Astras reguläre Ein- und Ausgabepreise sind jeweils 2,5-mal so hoch wie bei 5.6 Sol. 6 Sol und 6.1 Sol kosten jeweils die Hälfte von 5.6 Sol. Bei gleicher regulärer Token-Menge kostet Luna ein Hundertstel von Astra und eignet sich damit für große Mengen leicht überprüfbarer Aufgaben.
Für 5.6 Sol gilt derzeit ein Aktionspreis, laut OpenAI mindestens bis 21. November 2026. Danach ist eine erneute Prüfung nötig. Preishinweise zu 5.6 Sol
Token-Preis und Gesamtkosten einer abgeschlossenen Aufgabe sind verschieden. Ein stärkeres Modell benötigt möglicherweise weniger Token, Tool-Aufrufe oder Wiederholungen.
Rechenbeispiel: automatisierter Kundendienst
Ein System verarbeitet monatlich 1.000 Anfragen mit durchschnittlich 2.000 Eingabe-Token und 500 abrechenbaren Ausgabe-Token einschließlich Denk-Token. Das ergibt zwei Millionen Eingabe- und 500.000 Ausgabe-Token.
Bei festen Mengen und ohne Caching, Tools, Wiederholungen oder Zusatzkosten ergibt sich theoretisch:
| Modell | Monatliche API-Kosten im Beispiel |
|---|---|
| GPT-6 Astra | $45.00 |
| GPT-6.1 Sol | $9.00 |
| GPT-6 Luna | $0.45 |
Für 6.1 Sol: 2 Millionen ÷ 1 Million × $2 plus 500.000 ÷ 1 Million × $10 = $9. Astra kostet in diesem Beispiel 100-mal so viel wie Luna. Das sind Rechenwerte, keine gemessenen Durchschnittskosten.
Interne Denk-Token werden zum Ausgabepreis berechnet. Bezeichnen die „500 Ausgabe-Token“ nur die sichtbare Antwort, muss der Denkverbrauch hinzuaddiert werden. Abrechnung von Denk-Token
Für die Klassifikation von Anliegen, Bestellnummernextraktion und JSON-Ausgabe kann Luna genügen. Komplexe Vertragsstreitigkeiten, Beschwerdebelege und mehrstufige Geschäftsentscheidungen können stärkere Modelle rechtfertigen, wenn sie menschliche Nacharbeit reduzieren.
Weitere Abrechnungsregeln
Die wichtigsten GPT-6-Modelle bieten rund 1,05 Millionen Kontext-Token und bis zu 128K Ausgabe-Token. Diese Kapazität gab es bereits bei 5.6 Sol. Bei mehr als 272K Eingabe-Token gilt für die gesamte Anfrage der Langkontexttarif: Eingabe- und Cache-bezogene Preise verdoppeln sich, der Ausgabepreis steigt auf das 1,5-Fache.
Cache-Lesen und Cache-Schreiben sind verschieden. 6.1 Sol berechnet $0.10 je Million gelesener Cache-Token; der Standardpreis für das Schreiben beträgt $2.50.
Auch die Verarbeitungsklasse wirkt sich aus:
- Batch / Flex: üblicherweise 50% günstiger als Standard, mit Abwägungen bei Durchsatz, Warteschlange oder Latenz.
- Fast: üblicherweise zum doppelten Standardpreis für schnelleren Dienst.
- Ultrafast: bei 6.1 Sol zum sechsfachen API-Standardpreis für besonders zeitkritische Abläufe.
Die Verfügbarkeit hängt vom Modell ab. Ein Preisfaktor ist kein Geschwindigkeitsfaktor; unterstützte regionale Verarbeitung kann zusätzlich 10% kosten. vollständige API-Preisliste
ChatGPT-Tarife und Zugriff auf GPT-6
ChatGPT-Abonnements arbeiten mit Tarifen und Nutzungskontingenten; die API wird hauptsächlich nach Token und Verarbeitungsklasse abgerechnet. Plus enthält kein monatliches API-Guthaben von $20.
Die folgende Übersicht nennt offizielle monatliche Dollarpreise. Region, Steuern und tatsächliche Kontokonditionen können abweichen. Normaler Chat und Work/Codex sind getrennte Zugänge; Rechte des einen lassen sich nicht auf den anderen übertragen.
| Tarif | Monatspreis | GPT-6-bezogener Zugang |
|---|---|---|
| Free | Kostenlos | Normaler Chat wechselt schrittweise zu 5.6 Luna; separater 6-Luna-Rollout für Codex Desktop |
| Go | $8 auf der offiziellen US-Dollar-Seite; regionale Preise prüfen | 5.6 Luna im Chat; separater 6-Luna-Rollout für Codex Desktop |
| Plus | $20 | GPT-6 Sol im Chat; unter anderem Astra und 6.1 Sol in Work/Codex |
| Pro 100 | $100 | GPT-6 Pro und höhere Arbeitskontingente |
| Pro 200 | $200 | Höhere Kontingente für GPT-6 Pro, Work und Codex |
| Pro 500 | $500 | Höchstes Nutzungskontingent einschließlich Ultrafast-Zugang |
Der Codex-Desktop-Zugang zu 6 Luna für Free und Go hängt vom Rollout ab. Quellen sind die Dokumentation der Chat-Modelle, Work-/Codex-Preisseite und Erläuterungen zu Pro-Tarifen. Enterprise und Education haben eigene Zugangs- und Kontingentregeln.
Welches Modell steckt hinter GPT-6 im Chat?
In berechtigten bezahlten Chat-Tarifen gilt bei Auswahl von GPT-6:
| Denkstufe | Tatsächliches Modell |
|---|---|
| Instant | GPT-6 Sol |
| Medium | GPT-6 Sol |
| High | GPT-6 Sol |
| Extra High | GPT-6 Sol |
| Pro | GPT-6 Pro, angetrieben von GPT-6 Astra |
Plus bietet normalerweise Instant, Medium und High, jedoch nicht Extra High oder Pro im Chat. Höhere Tarife wie Pro bieten zusätzliche Stufen; maßgeblich ist die Kontoanzeige.
6.1 Sol ist derzeit kein separat auswählbares Modell im normalen Chat. Es ist hauptsächlich in Work, Codex und der API verfügbar. Fehlende Sichtbarkeit im Chat sagt nichts über den Work- oder Codex-Zugang aus. GPT-6 Pro hat außerdem ein eigenes Kontingent; ein Pro-Abonnement bedeutet keinen unbegrenzten Astra-Zugang.
Ultrafast bei Pro 500 ist nicht kostenlos: Es verbraucht enthaltene Nutzung zum achtfachen Standardkontingent-Satz des jeweiligen Modells. Werden nach Ausschöpfen des Kontingents Credits eingesetzt, gilt der sechsfache Standard-Credit-Satz.
Vor einem Upgrade sollte klar sein, ob mehr Aufgabenvolumen, ein stärkeres Modell oder geringere Latenz benötigt wird. Ergänzend: Codex-Kontingente und Zurücksetzung und ChatGPT Go oder Plus. Dokumentation der Chat-Modelle · Erläuterungen zu Pro-Tarifen
Welches GPT-6-Modell passt zu welcher Aufgabe?
Aufgabenkomplexität und Fehlerkosten sind sinnvolle Auswahlkriterien. Die Tabelle orientiert sich am offiziellen Leitfaden zur Modellauswahl und ist ein Ausgangspunkt für Tests, keine Erfolgsgarantie. Im normalen Chat gelten die sichtbaren Denkstufen; die Einstellbereiche von Work/Codex und API stehen in deren Dokumentation.
| Aufgabe | Modell zum Einstieg | Denkintensität |
|---|---|---|
| Klassifikation, Labels, Extraktion | GPT-6 Luna | None / Low |
| Häufige Support-Anfragen, einfache Textverarbeitung | GPT-6 Luna | Low / Medium |
| Alltäglicher ChatGPT-Chat | GPT-6 Sol | Instant |
| Lange Texte, gewöhnliche Analysen, Planungsdiskussionen | GPT-6 Sol | Medium / High |
| Gewöhnliche Programmierung, Fehlerkorrekturen | GPT-6.1 Sol | Medium |
| Refactoring mehrerer Dateien, komplexe Code-Reviews | GPT-6.1 Sol | High / XHigh |
| Große Softwareprojekte, komplexe Computerbedienung | GPT-6 Astra | Mit Medium beginnen, bei Bedarf High / Max |
| Anspruchsvolle Forschung und fachliches Schlussfolgern | GPT-6 Astra | Medium mit High / Max vergleichen |
| Geplante Massenautomatisierung | GPT-6 Luna, bei Bedarf Sol | Low / Medium |
Eine höhere Denkintensität führt möglicherweise zu mehr interner Prüfung, mehr Token und längerer Bearbeitungszeit. Bei klar umrissenen einfachen Aufgaben muss sie die Ergebnisse nicht verbessern.
Strategie 1: günstig beginnen und gezielt eskalieren
Ein mehrstufiges Routing lässt Luna Routineaufgaben bearbeiten. Fehlgeschlagene Regelprüfungen, widersprüchliche Angaben oder bekannte mehrstufige Probleme gehen an 6.1 Sol. Geschäftsregeln, Ausgabeprüfungen und Stichproben sollten entscheiden, nicht allein die vom Modell angegebene Sicherheit. Astra bearbeitet besonders schwierige oder folgenschwere Fälle.
Ein Support-System könnte Luna klassifizieren lassen, Vertragsstreitigkeiten mit Sol analysieren und wenige Hochrisikofälle von Astra vorprüfen lassen. Die endgültige Entscheidung bleibt beim Menschen. Das ist häufig günstiger als die Flaggschiff-Nutzung für jede Anfrage.
Strategie 2: Kosten pro erfolgreicher Aufgabe messen
Entscheidend sind die Gesamtkosten einer erfolgreich abgeschlossenen Aufgabe. Vereinfacht:
Gesamtkosten je Aufgabe = Modellkosten + Tool-Kosten + Wiederholungen + menschliche Korrekturen.
Benötigt ein günstiges Modell fünf Versuche und Astra nur einen, kann Astra insgesamt wirtschaftlicher sein. Bei Code zählen auch bestandene Tests, integrierbare Änderungen, angemessener Umfang und menschlicher Prüfaufwand.
Strategie 3: lange Aufgaben asynchron ausführen
Für Repository-Scans, Wochenberichte, Dokumentstapel oder lange Analysen ohne unmittelbare Antwortpflicht bietet sich 6.1 Sol mit asynchroner oder paralleler Ausführung an. Unabhängige Hintergrundaufgaben reduzieren menschliche Wartezeit, nicht automatisch die Gesamtkosten.
Bei interaktiven Produkten kann Luna, eine niedrigere Denkintensität oder eine schnellere Verarbeitungsklasse sinnvoller sein.
Strategie 4: Kontext-Caching nutzen
Stabile Systemanweisungen, Tool-Definitionen, Repository-Beschreibungen und andere cachefähige Präfixe helfen, statischen Kontext wiederzuverwenden. 6.1 Sol kostet beim Cache-Lesen $0.10 je Million Token. Tatsächliche Treffer müssen in den Nutzungsdaten geprüft werden; wiederholtes Senden garantiert keinen Cache-Tarif.
Eine gute Trefferquote kann in langen Abläufen erheblich sparen. Veraltete oder irrelevante Informationen müssen trotzdem entfernt werden: Caching ersetzt keine korrekte Kontextverwaltung.
Community-Erfahrungen: Codequalität, Kosten und Tempo
Die folgenden nachvollziehbaren Beispiele stammen vor allem von Reddit und Hacker News. Sie sind keine Zufallsstichprobe und bilden keine allgemeine Netzmeinung ab. Drei Muster fallen auf: Anerkennung für Astra bei Kritik am Verbrauch, Enttäuschung über 6 Sol gegenüber 5.6 und Zustimmung zu 6.1 Sols Kosten trotz längerer Wartezeit.
1. Astra: stark bei professioneller Arbeit, aber nicht überall überlegen
Reddit-Nutzer imadade berichtet in r/singularity, Astra löse Probleme, bei denen andere Modelle wiederholte Anleitung benötigten, und frage meist nur bei tatsächlich fehlenden Informationen nach. Besonders schätzt er das Urteilsvermögen bei Geschäfts- und Theoriefragen sowie die knappere Kommunikation. Reddit: erste Astra-Erfahrungen
Auf Hacker News berichtet ein Nutzer bei gleichen Prompts von relevanteren Quellen und besseren Lernmaterialien als mit 5.6 Sol. Ein anderer lobt Synthese und natürliche Sprache, kritisiert aber hohe Preise und schnell verbrauchte Kontingente. Entwickler berichten auch von Desktop-Automatisierungen, bei denen Astra wiederholt anhält und zum Fortfahren aufgefordert werden muss.
Leistungsfortschritt bedeutet also nicht automatisch ein besseres Gesamterlebnis für alle. Planung, Prompts, Umgebung und Kontingentverwaltung beeinflussen das Ergebnis. Hacker News: Astra-Erfahrungen
2. Sol: warum manche 5.6 bevorzugen
Jarr11 beschreibt in r/OpenAI 6 Sol als weniger gründlich und vollständig bei komplexen Aufgaben als 5.6 Sol. Für ihn entsteht eine Lücke zwischen einem zu schwachen Sol und einem zu teuren Astra; einige Kommentierende kehren zu 5.6 zurück. Reddit: 6 Sol als Nachfolger von 5.6?
Das sind reale Eindrücke, keine umfassenden kontrollierten Tests. Denkintensität, Tool-Rechte und Umgebung können viel verändern. Offizielle Benchmark-Fortschritte garantieren keine gleich große Verbesserung jedes bestehenden Workflows.
3. 6.1 Sol: 24 reale Codeaufgaben bei geringeren Kosten
bisonbear2 verglich 6 Sol und 6.1 Sol anhand von 24 bereits integrierten Änderungen eines Go-/TypeScript-Repositories. Beide Modelle bearbeiteten jede Aufgabe einmal mit Medium.
| Ergebnis im direkten Vergleich | GPT-6.1 Sol |
|---|---|
| Gewinnt gegen GPT-6 Sol | 9 Aufgaben |
| Gleichstand | 10 Aufgaben |
| Liegt hinter GPT-6 Sol | 5 Aufgaben |
In der Gesamtbewertung liegt 6.1 Sol leicht vorn. Fünf Niederlagen sind relative Vergleiche, nicht fünf fehlgeschlagene Aufgaben; daraus lässt sich keine Erfolgsquote ableiten. Die typischen Aufgabenkosten betragen etwa die Hälfte. Neben günstigerem Cache-Lesen verbraucht das Modell oft weniger Token.
Die Änderungen fallen allerdings größer aus und können mehr menschliche Prüfung verlangen. Der Zeitunterschied ist gering; 6.1 Sol ist nicht deutlich schneller. Die Auswertung beschreibt ihre Methode, umfasst aber nur ein Repository, 24 Aufgaben und einen Versuch pro Modell und Aufgabe. Ein Modellrichter fließt in die Gesamtbewertung ein, und der Autor entwickelt das Evaluierungswerkzeug Stet. Das begrenzt die Übertragbarkeit. Reddit: Vergleich mit 24 Codeaufgaben
4. Wie schnell ist 6.1 Sol? Ein Community-Test
Hot_Season8992 veröffentlichte in r/codex Messungen, bei denen alle Modelle XHigh verwendeten.
| Modell | Normal | Fast |
|---|---|---|
| GPT-5.6 Sol | 102.6 Token/s | 168.1 Token/s |
| GPT-6 Sol | 77.0 Token/s | 117.4 Token/s |
| GPT-6 Astra | 44.4 Token/s | 65.4 Token/s |
| GPT-6.1 Sol | 22.3 Token/s | 64.2 Token/s |
| GPT-6 Luna | 184.7 Token/s | 188.5 Token/s |
In diesem Test erreicht 6.1 Sol im Normal-Modus ungefähr ein Fünftel von 5.6 Sols Ausgabetempo. Fast beschleunigt 6.1 Sol deutlich, bleibt aber hinter 5.6 Sol Fast. Reddit: Geschwindigkeit von 6.1 Sol
Das sind Einzelmessungen zu einer bestimmten Zeit, Umgebung und Konfiguration, keine offiziellen Durchsatzgarantien. Konto, Auslastung und Anfrage verändern Ergebnisse. Token/s sind außerdem nicht die gesamte Aufgabendauer: Weniger Tools oder Wiederholungen können trotz langsamerer Ausgabe früher zum Ergebnis führen.
Auf Hacker News hält conception die Wartekosten für so hoch, dass manche Arbeit besser an schnellere Modelle geht. Andere Entwickler finden Tempo und Qualität unterhalb der höchsten Denkintensität akzeptabel. Hacker News: Wartezeiten bei 6.1 Sol
5. Weiterhin gegensätzliche Qualitätsurteile
Upper-Animator-5067 ließ 6.1 Sol mit Medium ein Dschungel-Minispiel nach einem vorgegebenen Entwicklungsablauf erstellen. Laut Bericht fehlten wichtige Funktionen, das Spiel war nicht ordentlich spielbar und auch Nachbesserungsaufträge lösten das Problem nicht. Reddit: enttäuschender Spieleentwicklungstest
Impossible-Sand5012 berichtet dagegen von zuverlässigen Ergebnissen und geringem Kontingentverbrauch bei mehreren parallelen Max-Aufgaben. Der Beitrag enthält keine vollständigen Verbrauchsprotokolle für einen direkten Vergleich. Reddit: langsamer, aber effizient
Langfristige Repository-Pflege, ein komplettes Spiel von Grund auf und interaktive Programmierung benötigen unterschiedliche Stärken.
Was lässt sich daraus ableiten?
Einige Nutzer bestätigen Astras hohe Leistungsgrenze, besonders bei professioneller Arbeit und komplexer Bedienung; es ist dennoch nicht bei jeder Aufgabe klar besser als 5.6. Beschwerden über 6 Sol zeigen, dass ein niedriger Preis Qualitätsprobleme mancher Workflows nicht ausgleicht, beweisen aber keinen universellen Rückschritt.
Im 24-Aufgaben-Bericht liegt 6.1 Sols Hauptgewinn bei den Kosten; der separate Geschwindigkeitstest mahnt zur Latenzmessung. Social-Media-Berichte sind verzerrt: Besonders gute und schlechte Erfahrungen werden eher veröffentlicht, während Denkstufe, Version, Last und Tools oft unkontrolliert bleiben. Sie zeigen Prüfbedarf, ersetzen aber keine eigenen Tests.
Wie sollten Entwickler GPT-6 praktisch evaluieren?
Für produktive Anwendungen empfiehlt sich zunächst ein kleiner Satz echter Aufgaben statt eines aufwendigen allgemeinen Benchmarks. Beispielsweise können 30 bis 50 kürzlich bearbeitete Aufgaben einfache, mittlere und schwierige Fälle abdecken. Das ist ein Startvorschlag, keine Garantie statistischer Repräsentativität.
Vergleichen Sie 6.1 Sol, Luna und Astra mit denselben Beschreibungen, Daten und Tool-Rechten. Erfassen Sie mindestens:
- Erfolg: Wurde die Aufgabe tatsächlich und anforderungsgemäß erledigt?
- Gesamtkosten: Eingabe, Ausgabe, Cache, Tools und Wiederholungen.
- Dauer: Zeit bis zu einem verwendbaren Ergebnis, nicht nur Token/s.
- Menschliche Eingriffe: Nachfragen, Korrekturen und Reparaturen.
Die Geschäftsziele entscheiden, nicht der erste Platz einer Rangliste. Für komplexe Aufgaben ist 6.1 Sol mit Medium ein guter Teststart; anschließend Low und High hinsichtlich Kosten und Erfolg vergleichen. Für standardisierte häufige Aufgaben zuerst Luna prüfen. Astra erst ergänzen, wenn reale Tests einen Bedarf nach höherer Leistung zeigen. So lassen sich Qualität, Tempo und Budget nachhaltig abwägen.
FAQ zu GPT-6
Welches GPT-6-Modell ist am stärksten?
OpenAI positioniert Astra für die schwierigsten Aufgaben. Entscheidend bleiben Erfolg, Dauer und Gesamtkosten. Für komplexe Alltagsprogrammierung zuerst 6.1 Sol testen, für Klassifikation und Extraktion Luna; nicht jede Anfrage braucht das Flaggschiff.
Ist GPT-6.1 Sol günstiger als GPT-6 Sol?
Reguläre Ein- und Ausgaben kosten gleich viel: $2 beziehungsweise $10 je Million Token. Cache-Lesen sinkt von $0.20 auf $0.10. Die Rechnung hängt auch von Denkverbrauch, Cache-Treffern, Tools und Nacharbeit ab; pauschal halbierte Kosten wären unzutreffend.
Kann ChatGPT Plus GPT-6.1 Sol verwenden?
Laut aktueller offizieller Beschreibung ist 6.1 Sol mit Plus in ChatGPT Work und Codex verfügbar. GPT-6 im normalen Chat folgt einer anderen Auswahl. Rollout, Client-Version und Kontorechte bestimmen den tatsächlichen Zugang.
Ist GPT-6.1 Sol immer langsamer als 5.6 Sol?
Der zitierte Community-Test misst in seiner Umgebung weniger Token/s. Das ist keine universelle Geschwindigkeitseigenschaft aller Anfragen. Vergleichen Sie die vollständige Aufgabendauer bei gleicher Aufgabe, Denkintensität und Verarbeitungsklasse.
Sollte ich vollständig von GPT-5.6 auf GPT-6 wechseln?
Behalten Sie 5.6 zunächst als Vergleich und testen Sie dieselben Aufgaben mit neuen Modellen. Wechseln Sie, wenn Qualität, Kosten oder Wartezeit den Aufwand rechtfertigen. Eine Anwendung kann Luna, Sol und Astra für unterschiedliche Aufgaben kombinieren.
Quellen
- offizielle Veröffentlichungszeitachse
- OpenAI-Modellverzeichnis
- Astra-Veröffentlichungsbericht
- Bewertung von 6.1 Sol
- Veröffentlichung von Sol und Luna
- 6.1-Sol-API-Dokumentation
- Preishinweise zu 5.6 Sol
- Abrechnung von Denk-Token
- vollständige API-Preisliste
- Dokumentation der Chat-Modelle
- Work-/Codex-Preisseite
- Erläuterungen zu Pro-Tarifen
- offiziellen Leitfaden zur Modellauswahl
- Reddit: erste Astra-Erfahrungen
- Hacker News: Astra-Erfahrungen
- Reddit: 6 Sol als Nachfolger von 5.6?
- Reddit: Vergleich mit 24 Codeaufgaben
- Reddit: Geschwindigkeit von 6.1 Sol
- Hacker News: Wartezeiten bei 6.1 Sol
- Reddit: enttäuschender Spieleentwicklungstest
- Reddit: langsamer, aber effizient
Offizielle Angaben und Preise geprüft am 16. Oktober 2026. Community-Zahlen stammen von den jeweiligen Autoren; wir haben diese Tests nicht unabhängig wiederholt.