Modelos GPT-6: cómo elegir Astra, Sol, Luna o 6.1 Sol
La familia GPT-6 incluye Astra, Sol, Luna y el nuevo GPT-6.1 Sol. Para trabajo complejo en Codex, ChatGPT Work o la API, empieza evaluando 6.1 Sol. Prueba Luna para clasificación y extracción a gran escala, y Astra para razonamiento difícil y entregas profesionales exigentes. La opción «GPT-6» del Chat habitual tiene otra correspondencia: no equivale automáticamente a 6.1 Sol.
OpenAI lanzó Astra el 3 de septiembre, Sol y Luna el 22 de septiembre y 6.1 Sol el 29 de septiembre de 2026. Frente a GPT-5.6, los cambios relevantes afectan a la ejecución de tareas complejas, la fiabilidad y el coste. Las experiencias discrepan: algunos valoran la capacidad profesional de Astra, otros critican el código de 6 Sol y otros cuestionan la espera de 6.1 Sol pese a su ahorro. Historial oficial de lanzamientos
Información comprobada el 16 de octubre de 2026. Precios en dólares estadounidenses. Se distinguen evaluaciones oficiales, mediciones de usuarios y recomendaciones editoriales.
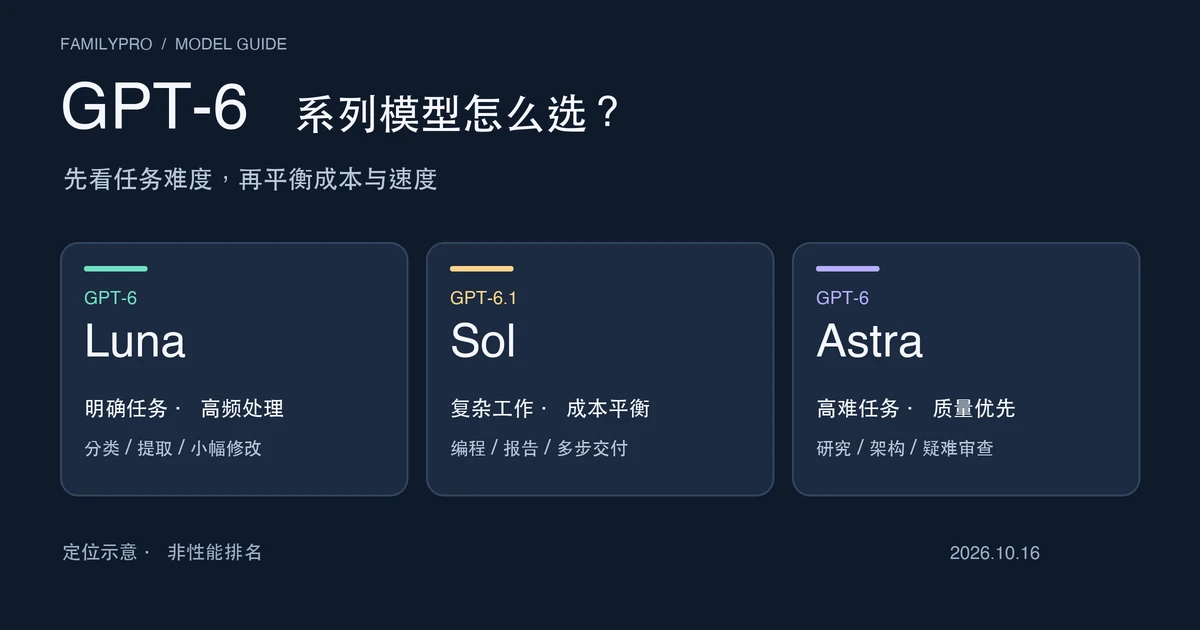
Ilustración editorial del posicionamiento de los modelos; no es una captura del producto ni un resultado de rendimiento.
Navegación rápida
- Modelos disponibles
- Mejoras frente a GPT-5.6
- Qué es 6.1 Sol
- Precios de la API
- Planes de ChatGPT
- Elección según la tarea
- Opiniones y pruebas de velocidad
- Preguntas frecuentes
¿Qué modelos GPT-6 existen?
| Modelo | Posicionamiento | Trabajo indicado |
|---|---|---|
| GPT-6 Astra | Modelo insignia, máxima capacidad | Razonamiento difícil, investigación, programación compleja, entregas profesionales |
| GPT-6 Sol | Primera opción equilibrada | Programación, herramientas, flujos de agentes |
| GPT-6.1 Sol | Opción equilibrada actualizada | Ingeniería de software compleja, trabajo profesional, agentes con presupuesto limitado |
| GPT-6 Luna | Ligero y eficiente | Procesamiento por lotes, clasificación, extracción, automatización frecuente |
Astra prioriza la calidad en tareas difíciles; 6.1 Sol busca acercarse a esa capacidad con menor coste; Luna prioriza rapidez y ahorro. El 6 Sol sigue disponible en la API, pero los proyectos nuevos pueden evaluar primero 6.1 Sol. La generación 5.6 incluía Sol, Terra y Luna; el catálogo actual de la generación 6 no tiene un Terra oficial equivalente. Catálogo de modelos OpenAI
Astra: máxima capacidad para trabajo exigente
Astra está orientado a grandes repositorios, investigación, informes empresariales, software profesional y operaciones prolongadas en el ordenador. Las herramientas disponibles siguen dependiendo del entorno, los permisos y la aplicación. Su precio hace costoso utilizarlo por defecto en cada solicitud sencilla.
Sol y 6.1 Sol: dos versiones del equilibrio
El 6 Sol acercó parte de la capacidad insignia a un nivel de precio inferior: sus tarifas ordinarias de entrada y salida son una quinta parte de las de Astra. Sin embargo, algunos usuarios habituales de 5.6 Sol señalan menor exhaustividad y estabilidad en trabajos complejos.
El 6.1 Sol llegó una semana después, con mejoras en ingeniería de software, comprensión documental, uso del ordenador y precisión factual. «Astra Lite» es un apodo comunitario, no un modelo oficial. El anuncio citado no establece la relación arquitectónica entre ambos y no demuestra que 6.1 Sol sea una versión comprimida de Astra.
Luna: ejecución económica a gran escala
Luna es el punto de partida para clasificar solicitudes de soporte, extraer datos estructurados, filtrar información, realizar cambios sencillos de código y automatizar rutinas. Distinguir un correo de reembolso de una reclamación rara vez exige razonamiento matemático de vanguardia.
GPT-6 frente a GPT-5.6: ¿qué mejora?
Programación e ingeniería compleja
Los siguientes datos son una instantánea del informe de lanzamiento de Astra y toman el mejor resultado de cada modelo entre varios niveles de razonamiento. No comparan un esfuerzo de razonamiento idéntico. Las evaluaciones de investigación/API pueden diferir del ChatGPT en producción; aquí no se han reproducido los ensayos. Informe de lanzamiento de Astra
| Prueba | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4.0 | 37.3% | 57.9% |
| DeepSWE v1.1 | 72.7% | 74.1% |
| FrontierCode 1.1 Main (puntuación) | 47.5 | 53.3 |
| Migración de bases de datos (interna) | 42.7% | 63.9% |
La mejora es de 20,6 puntos porcentuales en Terminal-Bench, pero solo de 1,4 en DeepSWE. La magnitud varía mucho según la evaluación: dos resultados no permiten clasificar todas las tareas de programación como mejoras grandes o pequeñas. Comprender el repositorio, ejecutar pruebas y entregar código integrable puede aportar más que generar código deprisa.
Uso del ordenador
OSWorld utiliza el conjunto sin conexión v2026.08.08; ScreenSpot-Pro, la configuración sin herramientas. OSWorld evalúa operaciones reales en el ordenador; ScreenSpot, la localización visual; AutomationBench, flujos empresariales entre herramientas. Informe de lanzamiento de Astra
| Prueba | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| OSWorld 2.0 (sin conexión, puntuación parcial) | 65.7% | 72.6% |
| ScreenSpot-Pro | 76.9% | 92.7% |
| AutomationBench | 18.1% | 41.4% |
En la simulación oficial de latencia de OSWorld, 5.6 Sol tarda unos 75 minutos por tarea con una puntuación del 65,7%; Astra, unos 40 minutos con el 72,6%. Son aproximadamente un 47% menos de tiempo simulado. Los porcentajes conceden crédito parcial y no representan la proporción de tareas completadas perfectamente. No garantizan igual aceleración en otros entornos.
Investigación, precisión factual y autorización
En el informe inicial de Astra, Terminal-Bench Science 0.1 pasa del 22,4% al 64,6%, y FrontierMath Tier 4 v2 del 83,0% al 97,6%. Los informes posteriores pueden actualizar resultados. Estas pruebas no sustituyen la validación independiente de métodos, datos, experimentos y conclusiones científicas. Informe de lanzamiento de Astra
OpenAI comunica aproximadamente la mitad de errores factuales del antecesor para 6 Sol en una evaluación especialmente difícil. Con 6.1 Sol y razonamiento bajo, las respuestas con errores bajan del 11,4% al 7,7%: 3,7 puntos porcentuales, alrededor del 32% relativo. Las muestras proceden de conversaciones difíciles donde usuarios habían señalado errores; no son tasas de error de uso cotidiano. Lanzamiento de Sol y Luna Lanzamiento y evaluación de 6.1 Sol
Astra también se ha entrenado para respetar mejor el alcance autorizado, reduciendo acciones adicionales sin permiso, informes engañosos de ejecución y desviaciones del objetivo. Un agente con acceso a archivos, navegadores y sistemas externos debe respetar los límites del encargo además de saber realizarlo.
Contexto en tareas prolongadas
Los resúmenes de conversaciones pueden perder detalles esenciales. El anuncio de Astra describe un mecanismo experimental de Codex para conservar notas de trabajo y recuperar contenido de ventanas anteriores, con el objetivo de reducir pérdidas durante depuración larga y refactorizaciones grandes. Consulta la documentación actual del cliente para disponibilidad y activación; el anuncio no establece un comportamiento predeterminado universal. La familia también mejora la caché de prompts, que puede ahorrar al releer repositorios, instrucciones y documentación empresarial. Informe de lanzamiento de Astra Lanzamiento de Sol y Luna
¿Qué es GPT-6.1 Sol y cómo difiere de 6 Sol?
Capacidad cercana en algunas pruebas con menor coste
En DeepSWE v1.1, OpenAI informa de que 6.1 Sol supera en 6,4 puntos porcentuales el mejor resultado de 6 Sol con menor esfuerzo y coste, e iguala a Astra por aproximadamente una quinta parte del coste por tarea. En OSWorld 2.0 sin conexión y en Max queda a un máximo de 2,1 puntos de Astra por alrededor de una séptima parte del coste. Son relaciones de evaluaciones y configuraciones específicas, no proporciones universales. Astra sigue recomendado para los problemas científicos más difíciles. Lanzamiento y evaluación de 6.1 Sol
Lectura de caché a mitad de precio
Las tarifas Standard siguen en 2 dólares por millón de tokens de entrada y 10 de salida. La lectura de entrada en caché baja de 0,20 dólares en 6 Sol a 0,10 en 6.1 Sol. Una pregunta aislada puede ahorrar poco; agentes que releen repositorios, herramientas e historial pueden acumular ahorro. Menos tokens en algunas tareas complejas también pueden reducir la factura.
Menor coste no garantiza menor latencia
La intención es completar la mayor parte del trabajo con un presupuesto sostenible. La rapidez depende del razonamiento, el modo de servicio y la carga; algunos desarrolladores lo consideran más lento que 5.6 Sol. Valora la ejecución en segundo plano para tareas largas y mide por separado la latencia interactiva.
6.1 Sol no admite none ni minimal: su mínimo es low. Compara Luna, que admite none, para trabajo sencillo. Las llamadas a herramientas con 6.1 Sol requieren Responses API; cambiar solo el identificador del modelo no completa la migración de una aplicación antigua. Documentación API de 6.1 Sol
Precios de la API GPT-6 y cálculo de costes
Tarifas Standard de texto, en dólares por millón de tokens, para solicitudes de hasta 272K tokens de entrada:
| Modelo | Entrada | Entrada en caché | Salida |
|---|---|---|---|
| GPT-5.6 Sol | $4.00 | $0.40 | $20.00 |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 |
| GPT-6 Sol | $2.00 | $0.20 | $10.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
Astra cuesta 2,5 veces 5.6 Sol en entrada/salida estándar. Ambas versiones 6 Sol cuestan la mitad de 5.6 Sol. Con iguales cantidades de entrada sin caché y salida, Luna cuesta una centésima parte de Astra. El precio de 5.6 Sol es promocional, previsto al menos hasta el 21 de noviembre de 2026; vuelve a comprobarlo después. Tarifas de 5.6 Sol
Un ejemplo mensual
Supongamos 1.000 solicitudes mensuales, con 2.000 tokens de entrada y 500 tokens de salida facturados, incluido el razonamiento, por solicitud. Son 2 millones de entrada y 0,5 millones de salida. Sin caché, herramientas, reintentos ni extras:
| Modelo | Coste mensual teórico de API |
|---|---|
| GPT-6 Astra | $45.00 |
| GPT-6.1 Sol | $9.00 |
| GPT-6 Luna | $0.45 |
Para 6.1 Sol: 2 × 2 dólares + 0,5 × 10 dólares = 9 dólares. Es aritmética de consumo fijo, no un promedio medido. Si 500 tokens solo describe la respuesta visible, añade el razonamiento interno, facturado como salida. Facturación de tokens de razonamiento
Luna puede bastar para clasificar casos, extraer pedidos y producir JSON. En disputas contractuales, pruebas de reclamaciones o decisiones multietapa, un modelo más fuerte puede ahorrar corrección humana. Compara coste por tarea completada con éxito, además de tarifas unitarias.
Reglas que cambian la factura
- Los principales modelos ofrecen unos 1,05 millones de tokens de contexto y hasta 128K de salida; 5.6 Sol ya tenía esa capacidad.
- Por encima de 272K tokens de entrada se aplican tarifas de contexto largo a toda la solicitud: entrada y tarifas relacionadas con caché se duplican; salida cuesta 1,5 veces el estándar.
- Lectura y escritura de caché son distintas: 6.1 Sol lee a 0,10 dólares y escribe a 2,50 por millón de tokens en Standard.
- Batch/Flex suelen costar un 50% menos que Standard, con compromisos de colas, capacidad o latencia. Fast suele costar el doble; Ultrafast de 6.1 Sol en API, seis veces Standard. La disponibilidad depende del modelo y los multiplicadores de precio no garantizan igual multiplicador de velocidad. El procesamiento regional compatible puede añadir un 10%.
Precios de ChatGPT y acceso a GPT-6
La suscripción ofrece uso según plan y límites; la API se factura aparte. Plus no incluye 20 dólares de saldo API. Estos son precios oficiales mensuales en dólares, sujetos a región, impuestos y pago real. Chat habitual y Work/Codex tienen permisos distintos.
| Plan | Cuota mensual | Acceso relacionado con GPT-6 |
|---|---|---|
| Free | Gratis | Chat pasa gradualmente a 5.6 Luna; despliegue separado de 6 Luna en Codex de escritorio |
| Go | $8 en la página oficial en dólares; consultar precio regional | Chat con 5.6 Luna; despliegue separado de 6 Luna en Codex de escritorio |
| Plus | $20 | Chat con 6 Sol; Astra y 6.1 Sol, entre otros, en Work/Codex |
| Pro 100 | $100 | GPT-6 Pro y más uso de trabajo |
| Pro 200 | $200 | Mayor uso de GPT-6 Pro, Work y Codex |
| Pro 500 | $500 | Nivel máximo de uso, incluido acceso a Ultrafast |
Free/Go en Codex de escritorio dependen del despliegue de 6 Luna; Chat habitual usa 5.6 Luna. Empresas y educación tienen reglas propias. Modelos en ChatGPT Precios de Work y Codex Niveles de ChatGPT Pro
¿Qué modelo es «GPT-6» en Chat?
| Nivel de pensamiento | Modelo |
|---|---|
| Instant | GPT-6 Sol |
| Medium | GPT-6 Sol |
| High | GPT-6 Sol |
| Extra High | GPT-6 Sol |
| Pro | GPT-6 Pro basado en GPT-6 Astra |
Plus normalmente ofrece Instant, Medium y High, sin Extra High ni Pro en Chat. Los planes superiores ofrecen niveles adicionales según la cuenta. 6.1 Sol no es actualmente una opción separada en Chat habitual; está disponible en Work, Codex y API. No verlo en Chat no determina el acceso desde otras interfaces. GPT-6 Pro tiene límites propios: una suscripción Pro no significa Astra ilimitado.
En Pro 500, Ultrafast consume el uso incluido a ocho veces la tasa estándar del modelo. Después, los Credits comprados se cobran a seis veces su tasa estándar. Decide si necesitas volumen, capacidad o menor latencia antes de mejorar el plan. Consulta límites y reinicios de Codex (en inglés) y ChatGPT Go frente a Plus (en inglés). Modelos en ChatGPT Niveles de ChatGPT Pro
Cómo elegir GPT-6 según la tarea
Son puntos de partida derivados de la guía oficial, no configuraciones garantizadas. Chat habitual usa sus niveles visibles; Work/Codex y API admiten sus propios ajustes. Guía oficial de selección
| Tarea | Modelo inicial | Razonamiento |
|---|---|---|
| Clasificación, etiquetas, extracción | GPT-6 Luna | None / Low |
| Soporte frecuente, texto sencillo | GPT-6 Luna | Low / Medium |
| Conversación cotidiana en ChatGPT | GPT-6 Sol | Instant |
| Artículos largos, análisis, planificación | GPT-6 Sol | Medium / High |
| Programación y corrección de errores | GPT-6.1 Sol | Medium |
| Refactorización entre archivos, revisión compleja | GPT-6.1 Sol | High / XHigh |
| Grandes proyectos, operaciones complejas de ordenador | GPT-6 Astra | Empezar en Medium; High / Max si hace falta |
| Investigación difícil, razonamiento especializado | GPT-6 Astra | Comparar Medium con High / Max |
| Automatización periódica por lotes | Luna; escalar a Sol si hace falta | Low / Medium |
Más razonamiento puede aumentar comprobaciones, tokens y tiempo sin mejorar tareas sencillas bien delimitadas.
Escalar según la complejidad
Empieza rutinas con Luna. Envía fallos de validación, información contradictoria o tareas multietapa conocidas a 6.1 Sol. Basa la decisión en reglas empresariales, comprobaciones y muestreo, sin fiarte solo de la confianza declarada del modelo. Reserva Astra para casos difíciles con errores costosos. Un soporte puede clasificar con Luna, analizar disputas con Sol y apoyarse en Astra en los casos de mayor riesgo, con decisión humana final.
Medir el coste completo
Coste por tarea = llamadas al modelo + herramientas + reintentos + corrección humana. Un modelo barato que necesita cinco intentos puede salir más caro que Astra resolviéndolo a la primera. En programación incluye pruebas, posibilidad de integrar el código, alcance de cambios y revisión.
Trabajo asíncrono y caché
Escanear repositorios, generar informes semanales, organizar documentos y analizar datos a largo plazo puede ejecutarse en segundo plano con 6.1 Sol. Paralelizar trabajo independiente reduce la espera humana, no necesariamente la factura. Productos interactivos pueden beneficiarse más de Luna, menor razonamiento o un servicio más rápido.
Mantén prompts de sistema, definiciones de herramientas e instrucciones del repositorio en prefijos estables. Comprueba los aciertos de caché reales: repetir contenido no implica facturarlo todo como caché. Elimina contexto obsoleto o irrelevante; la caché no sustituye esa gestión.
Opiniones de la comunidad: código, coste y velocidad
Estos casos rastreables de Reddit y Hacker News no son una muestra aleatoria ni representan toda la opinión pública. Combinan elogios a Astra con críticas a su consumo, preferencias por 5.6 y aceptación de la espera de 6.1 a cambio de ahorro.
Astra: capacidad profesional con límites prácticos
imadade, en Reddit, describió problemas empresariales y teóricos que antes exigían orientación repetida, ahora resueltos con comunicación concisa y preguntas adicionales principalmente cuando hacían falta. Reddit: primeras experiencias con Astra
En Hacker News, un usuario comparó prompts idénticos con 5.6 Sol y encontró más fuentes relevantes y mejores materiales de estudio con Astra. Otro elogió síntesis y lenguaje natural, pero criticó precio y agotamiento rápido del límite. Un relato de automatización de escritorio describió paradas repetidas que obligaban a pedir continuar. Herramientas, planificación, prompts y límites afectan al resultado. Hacker News: primeras opiniones sobre Astra
6 Sol: por qué algunos prefieren 5.6
Jarr11, en r/OpenAI, consideró 6 Sol menos exhaustivo y completo en trabajo complejo, mientras Astra resultaba demasiado caro. Algunos comentaristas volvieron a 5.6 Sol. Son experiencias de flujos concretos, no una evaluación general controlada; pueden variar razonamiento, herramientas y entorno. Los avances oficiales no prometen igual mejora en todos los flujos existentes. Reddit: 6 Sol frente a 5.6 Sol
6.1 Sol en 24 tareas reales de programación
bisonbear2 convirtió 24 cambios integrados de un repositorio Go/TypeScript en tareas, con una ejecución de cada modelo por tarea y razonamiento Medium:
| Comparación con GPT-6 Sol | GPT-6.1 Sol |
|---|---|
| Victorias | 9 |
| Empates | 10 |
| Derrotas | 5 |
6.1 Sol obtuvo una pequeña ventaja global y un coste típico cercano a la mitad, gracias a caché más barata y menos tokens. Produjo cambios más amplios, potencialmente con más revisión; los tiempos no difirieron de forma relevante. Cinco derrotas son comparaciones relativas, no cinco tareas fallidas, y no establecen tasa de éxito. Es un solo repositorio, una ejecución por modelo/tarea, con un juez de modelo en la puntuación; el autor también desarrolla Stet. No se puede generalizar a toda programación. Reddit: comparación de 24 tareas de código
Una medición comunitaria de velocidad
Hot_Season8992 midió todos los modelos en XHigh. Valores en tokens de salida por segundo:
| Modelo | Normal | Fast |
|---|---|---|
| GPT-5.6 Sol | 102.6 | 168.1 |
| GPT-6 Sol | 77.0 | 117.4 |
| GPT-6 Astra | 44.4 | 65.4 |
| GPT-6.1 Sol | 22.3 | 64.2 |
| GPT-6 Luna | 184.7 | 188.5 |
En esta prueba, 6.1 Sol Normal generó a aproximadamente una quinta parte de la velocidad de 5.6 Sol. Fast lo aceleró notablemente, pero siguió por debajo de 5.6 Fast. Son mediciones de un usuario en un momento y configuración concretos, no garantías oficiales; cuenta, carga y solicitud modifican resultados. Reddit: prueba de velocidad de 6.1 Sol
Tokens por segundo tampoco equivalen a tiempo total: menos herramientas o reintentos pueden compensar la generación lenta. conception, en Hacker News, consideró demasiado cara la espera y prefirió alternativas rápidas para parte del trabajo; otro desarrollador toleró mejor niveles inferiores de razonamiento. Hacker News: debate sobre latencia
La calidad sigue generando desacuerdo
Upper-Animator-5067 describió un juego de selva desarrollado en Medium con un flujo indicado: faltaban funciones importantes y seguía sin ser jugable después de pedir correcciones. Reddit: prueba de desarrollo de juego En cambio, Impossible-Sand5012 relató trabajo paralelo fiable en Max con poco consumo, sin registros completos comparables de uso. Reddit: experiencia positiva en tareas largas
Mantener un gran repositorio, crear un juego jugable y programar interactivamente requieren criterios distintos. Conviene ponderar calidad y consumo de Astra, conservar 5.6 como referencia cuando 6 Sol decepciona y medir por separado ahorro y latencia de 6.1. Quienes publican suelen tener experiencias especialmente buenas o malas; muchas comparaciones no controlan versión, razonamiento, carga ni herramientas. La comunidad ayuda a detectar problemas, pero no sustituye pruebas propias.
Cómo evaluar GPT-6 en tu trabajo
Selecciona entre 30 y 50 tareas recientes, fáciles, medias y difíciles. Es una sugerencia inicial, sin garantía de representatividad estadística. Compara Luna, 6.1 Sol y Astra con iguales datos, instrucciones y permisos.
Registra éxito real, gasto completo con caché/herramientas/reintentos, tiempo hasta un resultado utilizable e intervención humana. En programación compleja empieza con 6.1 Sol Medium y compara Low y High. Prueba primero Luna en funciones frecuentes estandarizadas; añade Astra cuando la calidad medida lo justifique. Así se equilibran calidad, rapidez y presupuesto.
Preguntas frecuentes sobre GPT-6 (FAQ)
¿Qué modelo GPT-6 es más potente?
OpenAI sitúa Astra para los trabajos más difíciles. Elige por éxito, coste total y tiempo: prueba 6.1 Sol para programación compleja habitual y Luna para clasificación o extracción.
¿GPT-6.1 Sol es más barato que GPT-6 Sol?
Ambos cobran 2 dólares de entrada y 10 de salida por millón de tokens en Standard. La lectura en caché baja de 0,20 a 0,10. El coste depende de razonamiento, caché, herramientas y retrabajo; no cuesta siempre la mitad.
¿ChatGPT Plus permite usar GPT-6.1 Sol?
La documentación oficial lo incluye para Plus en Work y Codex. Chat habitual tiene otro mapeo GPT-6. También influyen despliegue, versión del cliente y acceso de la cuenta.
¿GPT-6.1 Sol siempre es más lento que 5.6 Sol?
La prueba comunitaria citada no permite una conclusión universal. Compara tiempo completo de tareas equivalentes con igual razonamiento y modo de servicio, además de tokens por segundo.
¿Hay que migrar todos los flujos GPT-5.6?
Conserva 5.6 como referencia y compara tareas iguales. Migra cuando calidad, coste o espera mejoren lo suficiente; una aplicación también puede repartir trabajo entre Luna, Sol y Astra.
Referencias
- Historial oficial de lanzamientos
- Catálogo de modelos OpenAI
- Informe de lanzamiento de Astra
- Lanzamiento y evaluación de 6.1 Sol
- Lanzamiento de Sol y Luna
- Documentación API de 6.1 Sol
- Tarifas de 5.6 Sol
- Facturación de tokens de razonamiento
- Precios de OpenAI API
- Modelos en ChatGPT
- Precios de Work y Codex
- Niveles de ChatGPT Pro
- Guía oficial de selección
- Reddit: primeras experiencias con Astra
- Hacker News: primeras opiniones sobre Astra
- Reddit: 6 Sol frente a 5.6 Sol
- Reddit: comparación de 24 tareas de código
- Reddit: prueba de velocidad de 6.1 Sol
- Hacker News: debate sobre latencia
- Reddit: prueba de desarrollo de juego
- Reddit: experiencia positiva en tareas largas
Datos oficiales y precios comprobados el 16 de octubre de 2026. Las cifras comunitarias proceden de sus autores y no se han reproducido independientemente aquí.