Modèles GPT-6 : choisir Astra, Sol, Luna ou 6.1 Sol
La famille GPT-6 comprend Astra, Sol, Luna et le nouveau GPT-6.1 Sol. Pour un travail complexe dans Codex, ChatGPT Work ou l’API, commencez par évaluer 6.1 Sol. Essayez Luna pour la classification et l’extraction à grande échelle, et Astra pour les raisonnements difficiles et les livrables professionnels exigeants. L’option « GPT-6 » du Chat classique correspond à une autre sélection : elle ne désigne pas automatiquement 6.1 Sol.
OpenAI a lancé Astra le 3 septembre, Sol et Luna le 22 septembre, puis 6.1 Sol le 29 septembre 2026. Face à GPT-5.6, les progrès importants concernent l’exécution des tâches complexes, la fiabilité et le coût. Les expériences restent partagées : certains saluent les capacités professionnelles d’Astra, d’autres critiquent le code de 6 Sol ou l’attente avec 6.1 Sol malgré les économies. Historique officiel des lancements
Informations vérifiées le 16 octobre 2026. Prix en dollars américains. Évaluations officielles, mesures communautaires et recommandations éditoriales sont distinguées.
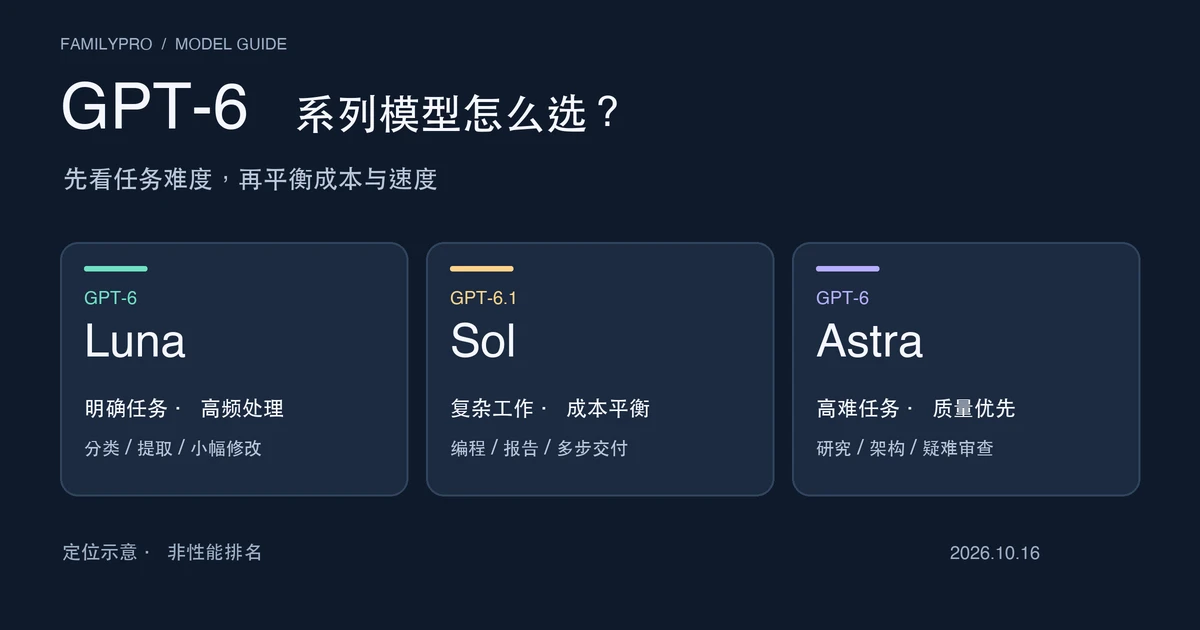
Illustration éditoriale du positionnement des modèles, et non capture du produit ou résultat de benchmark.
Accès rapide
- Modèles disponibles
- Progrès face à GPT-5.6
- Comprendre 6.1 Sol
- Tarifs API
- Abonnements ChatGPT
- Choisir selon la tâche
- Avis et tests de vitesse
- Questions fréquentes
Quels modèles GPT-6 sont disponibles ?
| Modèle | Positionnement | Travaux adaptés |
|---|---|---|
| GPT-6 Astra | Modèle phare, capacité maximale | Raisonnement difficile, recherche, programmation complexe, livrables professionnels |
| GPT-6 Sol | Première option équilibrée | Programmation, outils, flux de travail d’agents |
| GPT-6.1 Sol | Option équilibrée améliorée | Ingénierie logicielle complexe, travail professionnel, agents à budget limité |
| GPT-6 Luna | Léger et efficace | Traitement par lots, classification, extraction, automatisation fréquente |
Astra privilégie la qualité dans les travaux difficiles ; 6.1 Sol vise une capacité proche à moindre coût ; Luna privilégie rapidité et économie. Le 6 Sol reste accessible par API, mais les nouveaux projets peuvent commencer par évaluer 6.1 Sol. La génération 5.6 comportait Sol, Terra et Luna ; le catalogue actuel de la génération 6 ne présente pas d’équivalent officiel Terra. Catalogue des modèles OpenAI
Astra : la capacité maximale pour le travail exigeant
Astra vise les grands dépôts de code, la recherche, les rapports d’entreprise, les logiciels professionnels et les longues opérations sur ordinateur. Les outils accessibles dépendent toujours de l’environnement, des permissions et de l’application. Son prix rend coûteux son emploi systématique pour chaque demande simple.
Sol et 6.1 Sol : deux équilibres différents
Le 6 Sol a rendu une partie des capacités du modèle phare moins chère : ses tarifs ordinaires d’entrée et de sortie représentent un cinquième de ceux d’Astra. Certains utilisateurs réguliers de 5.6 Sol signalent cependant moins d’exhaustivité et de stabilité dans leurs travaux complexes.
Le 6.1 Sol est arrivé une semaine plus tard, avec des améliorations en ingénierie logicielle, compréhension documentaire, utilisation de l’ordinateur et exactitude factuelle. « Astra Lite » est un surnom communautaire, pas un nom officiel. L’annonce citée n’établit pas la relation architecturale entre les deux modèles et ne prouve pas que 6.1 Sol soit une version compressée d’Astra.
Luna : exécution économique à grande échelle
Luna constitue un point de départ pour classer les tickets, extraire des données structurées, filtrer l’information, modifier simplement du code et automatiser des routines. Reconnaître un courriel de remboursement ou de réclamation exige rarement un raisonnement mathématique de pointe.
GPT-6 face à GPT-5.6 : quels progrès ?
Programmation et ingénierie complexe
Les chiffres suivants proviennent du rapport de lancement d’Astra et retiennent le meilleur résultat de chaque modèle parmi plusieurs niveaux de raisonnement. Ils ne comparent pas un effort de raisonnement identique. Les évaluations de recherche/API peuvent différer de ChatGPT en production ; nous n’avons pas reproduit les tests. Rapport de lancement d’Astra
| Évaluation | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4.0 | 37.3% | 57.9% |
| DeepSWE v1.1 | 72.7% | 74.1% |
| FrontierCode 1.1 Main (score) | 47.5 | 53.3 |
| Migration de base de données (interne) | 42.7% | 63.9% |
Le gain atteint 20,6 points de pourcentage sur Terminal-Bench, mais seulement 1,4 sur DeepSWE. Il varie fortement selon l’évaluation : deux résultats ne permettent pas de ranger toutes les tâches de programmation dans des catégories de progrès forts ou faibles. Comprendre le dépôt, exécuter les tests et livrer du code intégrable peut compter davantage que générer rapidement du code.
Utilisation de l’ordinateur
OSWorld utilise le jeu hors ligne v2026.08.08 ; ScreenSpot-Pro, le réglage sans outils. OSWorld mesure les opérations réelles sur ordinateur, ScreenSpot le repérage visuel et AutomationBench les flux professionnels entre outils. Rapport de lancement d’Astra
| Évaluation | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| OSWorld 2.0 (hors ligne, crédit partiel) | 65.7% | 72.6% |
| ScreenSpot-Pro | 76.9% | 92.7% |
| AutomationBench | 18.1% | 41.4% |
Dans la simulation officielle de latence OSWorld, 5.6 Sol prend environ 75 minutes par tâche pour un score de 65,7 % ; Astra, environ 40 minutes pour 72,6 %. Cela représente environ 47 % de temps simulé en moins. Les scores accordent un crédit partiel et ne mesurent pas la proportion de tâches parfaitement terminées. Ils ne garantissent pas la même accélération dans un autre environnement.
Recherche, exactitude factuelle et autorisation
Dans le rapport initial d’Astra, Terminal-Bench Science 0.1 passe de 22,4 % à 64,6 %, et FrontierMath Tier 4 v2 de 83,0 % à 97,6 %. Des rapports ultérieurs peuvent actualiser ces résultats. Ces tests ne remplacent pas la vérification indépendante des méthodes, données, expériences et conclusions scientifiques. Rapport de lancement d’Astra
OpenAI annonce environ deux fois moins d’erreurs factuelles que le prédécesseur pour 6 Sol sur une évaluation particulièrement difficile. Avec 6.1 Sol au niveau de raisonnement faible, les réponses contenant des erreurs passent de 11,4 % à 7,7 % : baisse de 3,7 points, soit environ 32 % en relatif. Les exemples proviennent de conversations difficiles où les utilisateurs avaient signalé des erreurs ; ce ne sont pas des taux d’erreur de l’usage quotidien. Lancement de Sol et Luna Lancement et évaluation de 6.1 Sol
Astra a également été entraîné à mieux respecter le périmètre autorisé : moins d’actions supplémentaires sans permission, de comptes rendus trompeurs et d’écarts par rapport à l’objectif. Un agent ayant accès aux fichiers, au navigateur et aux systèmes externes doit respecter les limites du travail confié autant que savoir l’exécuter.
Contexte des tâches longues
Les résumés de conversations peuvent perdre des détails essentiels. L’annonce d’Astra décrit un mécanisme expérimental dans Codex permettant de conserver des notes de travail et de retrouver des contenus de fenêtres précédentes, pour réduire les pertes lors de longs débogages ou de grandes refactorisations. Consultez la documentation actuelle du client sur sa disponibilité et son activation : le lancement ne définit pas un comportement universel par défaut. La famille améliore aussi le cache des prompts, susceptible d’économiser lors de relectures de dépôts, d’instructions et de documents d’entreprise. Rapport de lancement d’Astra Lancement de Sol et Luna
Qu’est-ce que GPT-6.1 Sol et que change-t-il ?
Proche d’Astra sur certains tests, à moindre coût
Sur DeepSWE v1.1, OpenAI indique que 6.1 Sol dépasse de 6,4 points le meilleur score de 6 Sol avec moins de raisonnement et de coût, et rejoint Astra pour environ un cinquième du coût par tâche. Sur OSWorld 2.0 hors ligne au niveau Max, il se situe à moins de 2,1 points d’Astra pour environ un septième du coût. Ces rapports concernent des évaluations et réglages précis, pas toutes les tâches. Astra reste recommandé pour les problèmes scientifiques les plus difficiles. Lancement et évaluation de 6.1 Sol
Lecture du cache deux fois moins chère
Les tarifs Standard restent à 2 dollars par million de tokens d’entrée et 10 dollars de sortie. La lecture d’entrée en cache passe de 0,20 dollar pour 6 Sol à 0,10 pour 6.1 Sol. Une question isolée économisera peut-être peu ; les agents relisant dépôt, outils et historique peuvent cumuler des économies. Une consommation réduite de tokens sur certaines tâches complexes peut aussi faire baisser la facture.
Coût réduit ne signifie pas latence réduite
Le but est d’accomplir une grande part du travail avec un budget soutenable. La vitesse dépend du raisonnement, du mode de service et de la charge ; certains développeurs le trouvent plus lent que 5.6 Sol. Envisagez l’arrière-plan pour les tâches longues et mesurez séparément la latence des usages interactifs.
6.1 Sol n’accepte ni none ni minimal : son minimum est low. Comparez Luna, qui accepte none, pour le travail simple. L’appel d’outils avec 6.1 Sol exige la Responses API ; changer uniquement l’identifiant du modèle ne termine pas la migration d’une ancienne application. Documentation API de 6.1 Sol
Tarifs API GPT-6 et calcul des coûts
Tarifs Standard de texte, en dollars par million de tokens, pour les requêtes ne dépassant pas 272K tokens d’entrée :
| Modèle | Entrée | Entrée en cache | Sortie |
|---|---|---|---|
| GPT-5.6 Sol | $4.00 | $0.40 | $20.00 |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 |
| GPT-6 Sol | $2.00 | $0.20 | $10.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
Astra coûte 2,5 fois 5.6 Sol en entrée/sortie standard. Les deux versions 6 Sol coûtent la moitié de 5.6 Sol. À volumes égaux d’entrée non mise en cache et de sortie, Luna coûte un centième d’Astra. Le tarif de 5.6 Sol est promotionnel, annoncé au moins jusqu’au 21 novembre 2026 ; vérifiez-le de nouveau après cette date. Tarifs de 5.6 Sol
Exemple mensuel
Supposons 1 000 requêtes par mois, chacune avec 2 000 tokens d’entrée et 500 tokens de sortie facturés, raisonnement compris. Cela fait 2 millions en entrée et 0,5 million en sortie. Sans cache, outils, nouvelles tentatives ni suppléments :
| Modèle | Coût mensuel théorique API |
|---|---|
| GPT-6 Astra | $45.00 |
| GPT-6.1 Sol | $9.00 |
| GPT-6 Luna | $0.45 |
Pour 6.1 Sol : 2 × 2 dollars + 0,5 × 10 dollars = 9 dollars. C’est un calcul à consommation fixe, pas une moyenne mesurée. Si les 500 tokens désignent seulement la réponse visible, ajoutez le raisonnement interne, facturé au tarif de sortie. Facturation des tokens de raisonnement
Luna peut suffire à classer des tickets, extraire des commandes et produire du JSON. Sur les litiges contractuels, les preuves de réclamation ou les décisions à étapes multiples, un modèle plus puissant peut réduire la correction humaine. Comparez le coût par tâche réussie, au-delà du tarif unitaire.
Règles qui modifient la facture
- Les principaux modèles proposent environ 1,05 million de tokens de contexte et jusqu’à 128K de sortie ; 5.6 Sol offrait déjà cette capacité.
- Au-delà de 272K tokens d’entrée, les tarifs de contexte long s’appliquent à toute la requête : entrée et tarifs associés au cache doublés ; sortie à 1,5 fois le tarif standard.
- Lecture et écriture du cache diffèrent : 6.1 Sol lit à 0,10 dollar et écrit à 2,50 dollars par million de tokens en Standard.
- Batch/Flex coûtent généralement 50 % de moins que Standard, avec des compromis de file d’attente, débit ou latence. Fast coûte généralement le double ; Ultrafast de 6.1 Sol dans l’API, six fois Standard. La disponibilité varie selon le modèle et le multiplicateur de prix ne garantit pas celui de vitesse. Le traitement régional compatible peut ajouter 10 %.
Abonnements ChatGPT et accès aux modèles GPT-6
L’abonnement fournit un usage selon le forfait et ses quotas ; l’API se facture séparément. Plus n’inclut pas 20 dollars de crédit API. Voici les prix mensuels officiels en dollars, sous réserve de région, taxes et paiement réel. Chat classique et Work/Codex ont des droits distincts.
| Offre | Prix mensuel | Accès lié à GPT-6 |
|---|---|---|
| Free | Gratuit | Chat passe progressivement à 5.6 Luna ; déploiement séparé de 6 Luna dans Codex sur ordinateur |
| Go | $8 sur la page officielle en dollars ; consulter le prix régional | Chat avec 5.6 Luna ; déploiement séparé de 6 Luna dans Codex sur ordinateur |
| Plus | $20 | Chat avec 6 Sol ; Astra et 6.1 Sol, entre autres, dans Work/Codex |
| Pro 100 | $100 | GPT-6 Pro et davantage de travail |
| Pro 200 | $200 | Quotas supérieurs pour GPT-6 Pro, Work et Codex |
| Pro 500 | $500 | Palier d’usage maximal, avec accès à Ultrafast |
Free/Go dans Codex sur ordinateur dépendent du déploiement de 6 Luna ; Chat classique utilise 5.6 Luna. Entreprises et éducation ont leurs propres règles. Modèles dans ChatGPT Tarifs Work et Codex Niveaux ChatGPT Pro
Quel modèle se cache derrière « GPT-6 » dans Chat ?
| Niveau de réflexion | Modèle |
|---|---|
| Instant | GPT-6 Sol |
| Medium | GPT-6 Sol |
| High | GPT-6 Sol |
| Extra High | GPT-6 Sol |
| Pro | GPT-6 Pro basé sur GPT-6 Astra |
Plus propose normalement Instant, Medium et High, sans Extra High ni Pro dans Chat. Les offres supérieures donnent des niveaux supplémentaires selon le compte. 6.1 Sol n’est pas actuellement un choix séparé dans Chat classique ; il est proposé dans Work, Codex et l’API. Son absence dans Chat ne détermine pas son accès ailleurs. GPT-6 Pro possède son propre quota : un abonnement Pro ne signifie pas Astra illimité.
Dans Pro 500, Ultrafast consomme le quota inclus à huit fois le rythme standard du modèle. Après épuisement, les Credits achetés sont facturés à six fois le tarif standard des Credits. Déterminez si vous recherchez du volume, des capacités ou moins de latence avant de changer d’offre. Consultez les quotas et réinitialisations Codex (en anglais) et ChatGPT Go face à Plus (en anglais). Modèles dans ChatGPT Niveaux ChatGPT Pro
Choisir GPT-6 selon la tâche
Ces propositions sont des points de départ issus du guide officiel, pas des configurations garanties. Chat classique emploie ses niveaux visibles ; Work/Codex et l’API disposent de réglages propres. Guide officiel de sélection
| Tâche | Modèle de départ | Raisonnement |
|---|---|---|
| Classification, étiquettes, extraction | GPT-6 Luna | None / Low |
| Support fréquent, texte simple | GPT-6 Luna | Low / Medium |
| Conversation quotidienne dans ChatGPT | GPT-6 Sol | Instant |
| Articles longs, analyse, préparation de plans | GPT-6 Sol | Medium / High |
| Programmation et correction de bugs | GPT-6.1 Sol | Medium |
| Refactorisation multifichier, revue complexe | GPT-6.1 Sol | High / XHigh |
| Grands projets, opérations informatiques complexes | GPT-6 Astra | Commencer en Medium ; High / Max si nécessaire |
| Recherche difficile, raisonnement spécialisé | GPT-6 Astra | Comparer Medium à High / Max |
| Automatisation périodique par lots | Luna ; passer à Sol si nécessaire | Low / Medium |
Davantage de raisonnement peut accroître vérifications, tokens et temps sans améliorer une tâche simple bien délimitée.
Orienter selon la complexité
Commencez les routines avec Luna. Transférez les échecs de validation, informations contradictoires ou tâches connues à étapes multiples vers 6.1 Sol. Utilisez règles métier, vérification des sorties et échantillonnage, plutôt que la seule confiance déclarée du modèle. Réservez Astra aux cas difficiles où l’échec coûte cher. Un support peut classer avec Luna, analyser les litiges avec Sol et utiliser Astra en appui sur les dossiers les plus risqués, la décision finale restant humaine.
Mesurer le coût complet
Coût d’une tâche = appels au modèle + outils + nouvelles tentatives + correction humaine. Un modèle peu cher nécessitant cinq essais peut coûter plus qu’Astra réussissant du premier coup. Pour le code, incluez réussite des tests, possibilité d’intégration, ampleur des changements et temps de revue.
Travail asynchrone et cache
Analyse de dépôts, rapports hebdomadaires, classement documentaire et analyses longues peuvent tourner en arrière-plan avec 6.1 Sol. Exécuter des tâches indépendantes en parallèle réduit l’attente humaine, sans diminuer automatiquement la facture. Un produit interactif peut mieux profiter de Luna, d’un raisonnement plus faible ou d’un service plus rapide.
Stabilisez les préfixes contenant prompts système, définitions d’outils et instructions du dépôt. Vérifiez les accès réels au cache : répéter du contenu ne signifie pas que tout sera facturé au tarif cache. Retirez le contexte obsolète ou inutile ; le cache ne remplace pas cette gestion.
Avis de la communauté : code, coût et vitesse
Ces cas traçables de Reddit et Hacker News ne sont pas un échantillon aléatoire ni une mesure de l’opinion générale. Ils mêlent éloges d’Astra et critiques de sa consommation, préférences pour 5.6 et acceptation de l’attente de 6.1 en échange d’économies.
Astra : capacité professionnelle et limites pratiques
imadade, sur Reddit, décrit des problèmes professionnels et théoriques qui demandaient auparavant des instructions répétées, maintenant traités avec une communication concise et des questions supplémentaires surtout lorsqu’elles sont utiles. Reddit : premiers retours sur Astra
Sur Hacker News, un utilisateur a comparé des prompts identiques avec 5.6 Sol et trouvé davantage de sources pertinentes et de meilleurs supports d’apprentissage avec Astra. Un autre salue synthèse et langage naturel, mais critique prix et épuisement rapide du quota. Un retour d’automatisation sur ordinateur décrit des arrêts répétés imposant de demander la poursuite. Outils, planification, prompts et quotas influencent le résultat. Hacker News : premiers avis sur Astra
6 Sol : pourquoi certains préfèrent 5.6
Jarr11, sur r/OpenAI, trouve 6 Sol moins exhaustif et complet en travail complexe, tandis qu’Astra paraît trop cher. Certains commentateurs sont revenus à 5.6 Sol. Ce sont des expériences de flux précis, pas une évaluation générale contrôlée ; niveaux de raisonnement, outils et environnement peuvent différer. Les progrès officiels ne garantissent pas la même amélioration dans chaque flux existant. Reddit : 6 Sol face à 5.6 Sol
6.1 Sol sur 24 tâches réelles de code
bisonbear2 a transformé 24 modifications intégrées d’un dépôt Go/TypeScript en tâches, avec une exécution par modèle et par tâche au niveau Medium :
| Comparaison face à GPT-6 Sol | GPT-6.1 Sol |
|---|---|
| Victoires | 9 |
| Égalités | 10 |
| Défaites | 5 |
6.1 Sol obtient un léger avantage global, avec un coût typique proche de la moitié grâce à un cache moins cher et moins de tokens. Les changements sont plus larges, et peuvent demander plus de revue ; les durées ne diffèrent pas nettement. Les cinq défaites sont relatives, pas cinq tâches échouées, et ne permettent pas de calculer un taux de réussite. Il s’agit d’un dépôt, d’un essai par modèle/tâche, avec un juge de modèle dans la notation ; l’auteur développe aussi Stet. Le résultat ne se généralise pas à toute programmation. Reddit : comparaison de 24 tâches de code
Un test communautaire de vitesse
Hot_Season8992 a mesuré tous les modèles en XHigh. Valeurs en tokens de sortie par seconde :
| Modèle | Normal | Fast |
|---|---|---|
| GPT-5.6 Sol | 102.6 | 168.1 |
| GPT-6 Sol | 77.0 | 117.4 |
| GPT-6 Astra | 44.4 | 65.4 |
| GPT-6.1 Sol | 22.3 | 64.2 |
| GPT-6 Luna | 184.7 | 188.5 |
Dans ce test, 6.1 Sol Normal génère à environ un cinquième de la vitesse de 5.6 Sol. Fast l’accélère nettement, mais reste sous 5.6 Fast. Ce sont les mesures d’un utilisateur à un moment et dans une configuration donnés, pas une garantie officielle ; compte, charge et requêtes changent les résultats. Reddit : mesure de vitesse de 6.1 Sol
Les tokens par seconde ne donnent pas non plus la durée totale : moins d’outils ou de tentatives peuvent compenser une génération lente. conception, sur Hacker News, juge l’attente trop coûteuse et préfère des modèles rapides pour certains travaux ; un autre développeur trouve un raisonnement inférieur plus acceptable. Hacker News : débat sur la latence
La qualité continue de diviser
Upper-Animator-5067 décrit un jeu de jungle réalisé en Medium selon un flux de développement indiqué : des fonctions importantes manquent et le jeu reste insuffisamment jouable après les demandes de correction. Reddit : test de développement de jeu À l’inverse, Impossible-Sand5012 rapporte du travail parallèle fiable en Max avec une faible consommation, sans relevés complets permettant une comparaison indépendante. Reddit : retour positif sur les tâches longues
Entretenir un grand dépôt, créer un jeu jouable et programmer de façon interactive nécessitent des critères différents. Ces récits invitent à comparer qualité et quota d’Astra, garder 5.6 comme référence si 6 Sol déçoit, et mesurer séparément économie et latence de 6.1. Les personnes publiant ont souvent une expérience particulièrement bonne ou mauvaise ; beaucoup de tests ne contrôlent ni version, ni raisonnement, ni charge, ni outils. La communauté aide à repérer les problèmes, mais ne remplace pas vos propres essais.
Évaluer GPT-6 sur votre travail
Sélectionnez 30 à 50 tâches récentes, faciles, moyennes et difficiles. C’est un point de départ pratique, sans garantie de représentativité statistique. Comparez Luna, 6.1 Sol et Astra avec les mêmes données, consignes et permissions.
Relevez la réussite réelle, le coût complet avec cache/outils/tentatives, le temps jusqu’à un résultat exploitable et l’intervention humaine. Pour le code complexe, commencez avec 6.1 Sol Medium puis comparez Low et High. Essayez Luna d’abord pour les fonctions fréquentes standardisées ; ajoutez Astra quand la qualité mesurée le justifie. Vous pourrez ainsi équilibrer qualité, vitesse et budget.
Questions fréquentes sur GPT-6 (FAQ)
Quel modèle GPT-6 est le plus puissant ?
OpenAI positionne Astra pour les travaux les plus difficiles. Choisissez selon réussite, coût total et durée : essayez 6.1 Sol pour la programmation complexe quotidienne et Luna pour classification ou extraction.
GPT-6.1 Sol coûte-t-il moins cher que GPT-6 Sol ?
Les deux facturent 2 dollars d’entrée et 10 de sortie par million de tokens en Standard. La lecture du cache passe de 0,20 à 0,10 dollar. La facture dépend de raisonnement, cache, outils et reprises ; elle n’est pas toujours divisée par deux.
ChatGPT Plus permet-il d’utiliser GPT-6.1 Sol ?
La documentation officielle le prévoit pour Plus dans Work et Codex. Chat classique possède un autre mappage GPT-6. Déploiement, version du client et droits du compte comptent aussi.
GPT-6.1 Sol est-il toujours plus lent que 5.6 Sol ?
Le test communautaire cité ne permet pas cette conclusion universelle. Comparez la durée complète de tâches équivalentes avec les mêmes niveaux de raisonnement et modes de service, au-delà des tokens par seconde.
Faut-il migrer tous les flux GPT-5.6 ?
Gardez 5.6 comme référence et comparez les mêmes tâches. Migrez quand qualité, coût ou attente s’améliorent suffisamment ; une application peut aussi répartir le travail entre Luna, Sol et Astra.
Références
- Historique officiel des lancements
- Catalogue des modèles OpenAI
- Rapport de lancement d’Astra
- Lancement et évaluation de 6.1 Sol
- Lancement de Sol et Luna
- Documentation API de 6.1 Sol
- Tarifs de 5.6 Sol
- Facturation des tokens de raisonnement
- Tarifs de l’API OpenAI
- Modèles dans ChatGPT
- Tarifs Work et Codex
- Niveaux ChatGPT Pro
- Guide officiel de sélection
- Reddit : premiers retours sur Astra
- Hacker News : premiers avis sur Astra
- Reddit : 6 Sol face à 5.6 Sol
- Reddit : comparaison de 24 tâches de code
- Reddit : mesure de vitesse de 6.1 Sol
- Hacker News : débat sur la latence
- Reddit : test de développement de jeu
- Reddit : retour positif sur les tâches longues
Données officielles et tarifs vérifiés le 16 octobre 2026. Les chiffres communautaires sont déclarés par leurs auteurs et n’ont pas été reproduits indépendamment ici.