GPT-6 a confronto: come scegliere Astra, Sol, Luna e 6.1 Sol
La famiglia GPT-6 comprende Astra, Sol, Luna e il più recente GPT-6.1 Sol. Per lavori complessi in Codex, ChatGPT Work o tramite API, conviene iniziare valutando 6.1 Sol. Luna è il primo candidato per classificazione ed estrazione su larga scala; Astra per ragionamento particolarmente difficile, ricerca e risultati professionali impegnativi. Il nome «GPT-6» nella normale chat di ChatGPT segue una diversa corrispondenza fra modelli e non equivale automaticamente a 6.1 Sol.
Nel settembre 2026 OpenAI ha presentato Astra il 3, Sol e Luna il 22 e 6.1 Sol il 29, costruendo una gamma per esigenze e budget differenti. cronologia ufficiale delle uscite
Rispetto a GPT-5.6 contano soprattutto l'esecuzione di lavori complessi, la probabilità di completarli e il costo. Le esperienze restano contrastanti: alcuni apprezzano Astra nel lavoro professionale, altri criticano il codice di 6 Sol; il costo inferiore di 6.1 Sol si accompagna a lamentele sui tempi di attesa. Benchmark ufficiali, esempi di spesa e discussioni verificabili aiutano a scegliere.
Fonti verificate il 16 ottobre 2026. Prezzi in dollari statunitensi. Valutazioni ufficiali, prove della community e suggerimenti editoriali sono distinti.
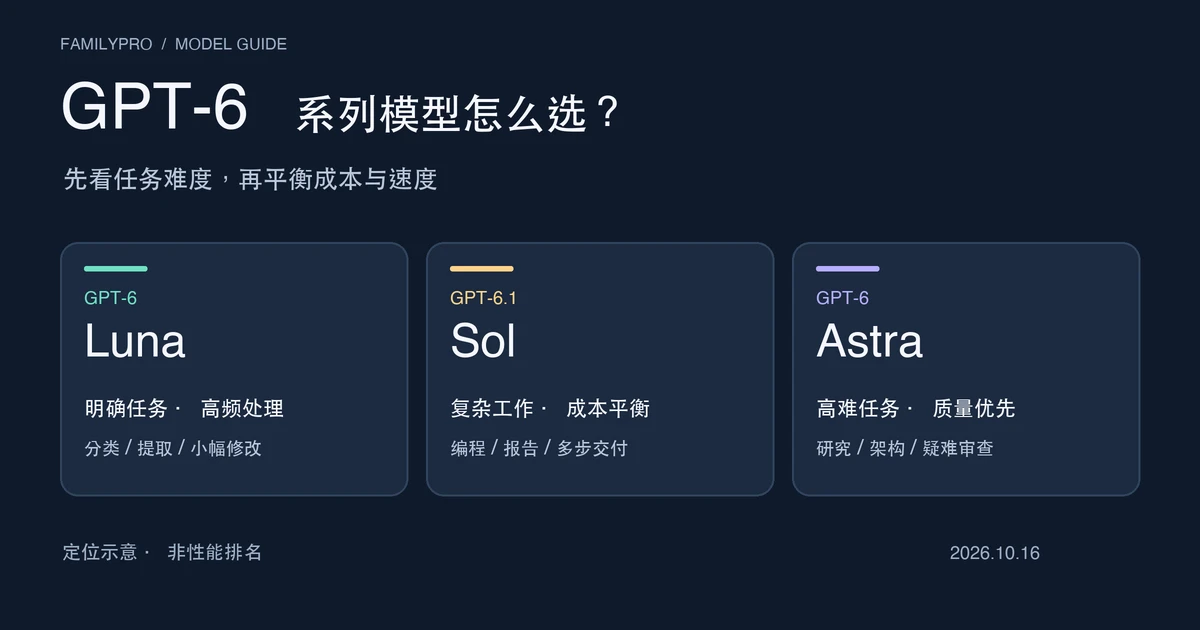
Illustrazione editoriale del posizionamento dei modelli, non una schermata del prodotto né un benchmark.
Navigazione rapida
- Quali modelli GPT-6 esistono
- Cosa cambia rispetto a GPT-5.6
- 6.1 Sol rispetto a 6 Sol
- Prezzi API ed esempi di costo
- Piani ChatGPT e accesso
- Scegliere in base al lavoro
- Opinioni e test di velocità
- FAQ
Quali modelli fanno parte della serie GPT-6?
La gamma comprende quattro modelli distinti, con Sol disponibile nelle versioni 6 e 6.1.
| Modello | Posizionamento | Lavori più adatti |
|---|---|---|
| GPT-6 Astra | Modello di punta, massima capacità | Ragionamento difficile, ricerca, programmazione complessa, risultati professionali |
| GPT-6 Sol | Primo modello equilibrato | Programmazione, strumenti e flussi di agenti |
| GPT-6.1 Sol | Modello equilibrato aggiornato | Sviluppo complesso, lavoro professionale quotidiano, agenti attenti ai costi |
| GPT-6 Luna | Modello leggero ed efficiente | Elaborazioni in massa, classificazione, estrazione, automazioni frequenti |
Astra privilegia la qualità finale; 6.1 Sol punta ad avvicinarne alcune capacità riducendo molto i costi; Luna privilegia velocità ed economicità. GPT-6 Sol resta accessibile tramite API, ma nei progetti nuovi ha generalmente senso valutare prima 6.1 Sol.
La famiglia 5.6 comprendeva Sol, Terra e Luna. Attualmente non esiste un corrispondente GPT-6 Terra ufficiale: 6.1 Sol occupa di fatto la fascia intermedia della nuova generazione. catalogo modelli OpenAI
GPT-6 Astra: il modello di punta
OpenAI presenta Astra come il suo modello generalista attualmente più capace, destinato a lavori che richiedono ragionamento approfondito e risultati di alta qualità. Gli esempi comprendono grandi repository, rapporti aziendali complessi, software professionale, ricerca e operazioni al computer lunghe e articolate.
L'attenzione è rivolta all'uso degli strumenti e al completamento dell'intero lavoro. L'efficacia dipende comunque dagli strumenti e dai permessi dell'applicazione. Il prezzo sensibilmente più elevato degli altri GPT-6 lo rende poco conveniente per alcune attività.
GPT-6 Sol: il primo compromesso fra capacità e costo
Sol porta parte delle capacità di punta in una fascia meno costosa, soprattutto per programmazione, lavoro professionale e agenti. I prezzi API standard di input e output sono entrambi un quinto di quelli di Astra.
Le reazioni sono divise: alcuni sviluppatori abituati a 5.6 Sol ritengono che il risparmio comporti una minore completezza e stabilità nell'esecuzione di lavori complessi.
GPT-6.1 Sol: capacità complesse con maggiore efficienza
6.1 Sol è arrivato una settimana dopo 6 Sol. L'obiettivo dichiarato è offrire capacità vicine ad Astra a un costo molto inferiore, migliorando ingegneria del software, comprensione dei documenti, uso del computer e accuratezza fattuale.
La community lo chiama talvolta «Astra Lite», ma non è un nome ufficiale. Le fonti ufficiali qui citate non descrivono la relazione fra le architetture: non dimostrano quindi che sia una versione compressa di Astra.
GPT-6 Luna: esecuzione economica di compiti chiari
Luna è il modello più economico e orientato alla rapidità della gamma. È adatto a classificare ticket di assistenza, estrarre dati strutturati, fare semplici modifiche al codice, filtrare informazioni e automatizzare operazioni ordinarie.
Per distinguere una richiesta di rimborso da un reclamo non serve normalmente un modello al vertice nel ragionamento matematico. Le attività frequenti e ben delimitate sono il principale campo d'impiego di Luna.
GPT-6 contro GPT-5.6: quali miglioramenti?
I dati ufficiali mostrano progressi soprattutto nei lavori complessi e nell'esecuzione tramite strumenti, senza miglioramenti uniformi su ogni attività.
1. Programmazione: progressi diversi secondo il benchmark
Questi valori provengono dal rapporto di lancio di Astra. Sono una fotografia di quel rapporto e usano il miglior risultato ottenuto a diverse intensità di ragionamento: non confrontano impostazioni identiche. I modelli sono stati valutati in ambienti di ricerca o API; ChatGPT in produzione può comportarsi diversamente. Non abbiamo ripetuto autonomamente i test.
| Benchmark | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4.0 | 37.3% | 57.9% |
| DeepSWE v1.1 | 72.7% | 74.1% |
| FrontierCode 1.1 Main (punteggio) | 47.5 | 53.3 |
| Migrazioni di database (interno) | 42.7% | 63.9% |
Astra guadagna 20,6 punti percentuali in Terminal-Bench, ma solo 1,4 in DeepSWE. GPT-6 non è quindi enormemente superiore a 5.6 in ogni attività di programmazione. I risultati giustificano prove mirate sui lavori complessi da terminale, ma due punteggi non bastano a classificare tutti i lavori di sviluppo in categorie di miglioramento ampio o ridotto.
Per chi sviluppa può contare più la capacità di comprendere il repository, eseguire test e consegnare codice integrabile che la sola velocità di generazione.
2. Computer Use: dalle risposte alle operazioni sul computer
L'uso del computer è una delle principali aree di miglioramento. La tabella segue le condizioni del rapporto di lancio di Astra: OSWorld usa il set offline v2026.08.08, ScreenSpot-Pro è senza strumenti.
| Benchmark | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| OSWorld 2.0 (offline, credito parziale) | 65.7% | 72.6% |
| ScreenSpot-Pro | 76.9% | 92.7% |
| AutomationBench | 18.1% | 41.4% |
OSWorld misura lavori reali svolti al computer; ScreenSpot-Pro la localizzazione di elementi nelle interfacce visive; AutomationBench soprattutto flussi aziendali che attraversano più strumenti.
Nella simulazione ufficiale di latenza OSWorld, 5.6 Sol richiede circa 75 minuti per attività con punteggio 65,7%, Astra circa 40 minuti con 72,6%. Viene attribuito credito parziale: le percentuali non sono quote di attività completate integralmente. La durata simulata scende di circa il 47% mentre il punteggio sale. Il risultato dipende da quello specifico ambiente e non garantisce lo stesso vantaggio nel lavoro reale.
3. Ricerca: ragionamento più impegnativo
In Terminal-Bench Science 0.1, 5.6 Sol ottiene 22,4% e Astra 64,6%. In FrontierMath Tier 4 (v2), i valori sono rispettivamente 83,0% e 97,6%.
Sono risultati del rapporto di lancio di Astra; rapporti successivi possono riportare dati aggiornati. Dimostrano progressi nei test citati, non un incremento equivalente in tutta la ricerca. Punteggi elevati non sostituiscono la verifica indipendente di metodi, dati, esperimenti e conclusioni scientifiche.
4. Accuratezza fattuale e rispetto dei limiti operativi
OpenAI dichiara che, in una valutazione fattuale difficile costruita appositamente, 6 Sol produce circa la metà degli errori della generazione precedente. 6.1 Sol migliora ancora: con ragionamento basso, la quota di risposte contenenti errori passa dall'11,4% al 7,7%.
La riduzione è di 3,7 punti percentuali, circa il 32% in termini relativi. I campioni provengono da conversazioni difficili nelle quali gli utenti avevano segnalato errori: entrambe le presentazioni precisano che non rappresentano il tasso di errore quotidiano. valutazione ufficiale di 6.1 Sol
Astra è inoltre addestrato a rispettare più accuratamente l'autorizzazione ricevuta, riducendo azioni extra non consentite, resoconti fuorvianti e deviazioni dall'obiettivo nei lavori con agenti. Un modello che opera su file, browser e sistemi esterni deve capire anche quali azioni non può intraprendere di propria iniziativa.
5. Gestione del contesto nei lavori lunghi
OpenAI ha presentato per Astra in Codex un sistema sperimentale di conservazione del contesto. I riassunti tradizionali di conversazioni lunghe possono perdere dettagli; il sistema descritto permette di conservare appunti e recuperare contenuti da finestre precedenti, aiutando nel debugging prolungato e nei grandi refactoring.
Disponibilità e attivazione vanno controllate nella documentazione attuale del client: la presentazione iniziale non prova che sia il comportamento predefinito ovunque. La gamma migliora anche la cache dei prompt. Riutilizzare repository, documenti aziendali e istruzioni di sistema può ridurre direttamente i costi degli agenti aziendali. rapporto di lancio di Astra · presentazione di Sol e Luna
Cos'è GPT-6.1 Sol e come cambia rispetto a 6 Sol?
Se Astra rappresenta il massimo delle capacità, 6.1 Sol rappresenta un nuovo equilibrio di efficienza economica.
Alcuni risultati vicini ad Astra a un quinto del prezzo standard
In alcuni test di software, documenti e uso del computer, 6.1 Sol si avvicina ad Astra con un costo per attività molto inferiore. In DeepSWE v1.1, OpenAI riporta 6,4 punti percentuali sopra il miglior punteggio di 6 Sol, con intensità di ragionamento e costo inferiori. Raggiunge inoltre un risultato equivalente ad Astra a circa un quinto del costo per attività.
In OSWorld 2.0 offline con ragionamento massimo (Max), il distacco da Astra è entro 2,1 punti percentuali, con circa un settimo della spesa per attività. «Vicino ad Astra» riguarda quindi specifici test e impostazioni, non tutti i lavori. OpenAI continua a consigliare Astra per la ricerca più difficile. valutazione ufficiale di 6.1 Sol
Cache: la lettura costa la metà rispetto a 6 Sol
I prezzi standard restano $2 per milione di token di input e $10 per milione di output. Cambia la lettura dalla cache: da $0.20 con 6 Sol a $0.10 con 6.1 Sol.
Per una domanda occasionale il risparmio può essere minimo; un agente di sviluppo rilegge invece codice, definizioni degli strumenti e cronologia. Se quei contenuti beneficiano della cache, il risparmio si accumula. Un eventuale uso inferiore di token nei lavori complessi riduce ulteriormente il costo effettivo.
Il costo basso non garantisce bassa latenza
Molti sviluppatori cercano un modello capace di svolgere la maggior parte del lavoro senza consumare rapidamente il budget. È l'obiettivo di 6.1 Sol. Economico non significa però rapido. Modalità di servizio, ragionamento e carico incidono sulla velocità; alcuni lo trovano sensibilmente più lento di 5.6 Sol.
Se i propri test confermano attese lunghe, può essere adatto a lavori complessi in background. Per le interazioni in tempo reale bisogna misurare la latenza. 6.1 Sol non supporta none né minimal: il minimo è low. Per compiti semplici si può confrontare Luna, che supporta none. Per invocare strumenti con 6.1 Sol serve la Responses API: sostituire soltanto l'ID del modello in una vecchia applicazione non completa la migrazione. documentazione API di 6.1 Sol
Prezzi API di GPT-6 ed esempi di costo
La tabella usa i prezzi ufficiali Standard in dollari per milione di token, per normali richieste testuali fino a 272K token di input.
| Modello | Input | Input dalla cache | Output |
|---|---|---|---|
| GPT-5.6 Sol | $4.00 | $0.40 | $20.00 |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 |
| GPT-6 Sol | $2.00 | $0.20 | $10.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
Input e output ordinari di Astra costano 2,5 volte quelli di 5.6 Sol. 6 Sol e 6.1 Sol costano entrambi la metà. A parità di token ordinari, Luna costa un centesimo di Astra: conviene valutarlo per molti compiti facilmente verificabili.
5.6 Sol usa attualmente un prezzo promozionale che OpenAI indica valido almeno fino al 21 novembre 2026; successivamente va ricontrollato. note sul prezzo di 5.6 Sol
Prezzo unitario e costo totale per completare un lavoro non sono la stessa cosa. Un modello più capace potrebbe usare meno token, chiamate agli strumenti o tentativi.
Esempio: assistenza clienti automatizzata
Un sistema elabora 1.000 richieste mensili, ciascuna con mediamente 2.000 token di input e 500 token di output fatturabili inclusi quelli di ragionamento: due milioni di input e 500.000 di output al mese.
Il seguente è un calcolo a consumo fisso, non una media misurata; esclude cache, strumenti, tentativi aggiuntivi e altri servizi.
| Modello | Costo API mensile teorico |
|---|---|
| GPT-6 Astra | $45.00 |
| GPT-6.1 Sol | $9.00 |
| GPT-6 Luna | $0.45 |
Per 6.1 Sol: 2 milioni ÷ 1 milione × $2, più 500.000 ÷ 1 milione × $10 = $9. Nell'esempio Astra costa 100 volte Luna.
Anche i token interni di ragionamento sono fatturati come output. Se i «500 token» descrivono solo la risposta visibile, il ragionamento va aggiunto. fatturazione dei token di ragionamento
Per classificare richieste, estrarre numeri d'ordine e produrre JSON, è sensato verificare prima Luna. Controversie contrattuali, analisi delle prove di un reclamo e decisioni articolate possono giustificare modelli più forti se riducono la correzione manuale.
Altre regole di fatturazione
I principali GPT-6 offrono circa 1,05 milioni di token di contesto e fino a 128K di output, capacità già presente in 5.6 Sol. Oltre 272K token di input si applica all'intera richiesta la tariffa di contesto lungo: input e tariffe legate alla cache raddoppiano, output sale a 1,5 volte lo standard.
Leggere e scrivere la cache sono operazioni diverse. 6.1 Sol costa $0.10 per milione di token letti dalla cache, mentre il prezzo standard di scrittura è $2.50.
Esistono inoltre più livelli di elaborazione:
- Batch / Flex: normalmente il 50% in meno di Standard, con compromessi su throughput, code o latenza.
- Fast: normalmente il doppio di Standard per un servizio più veloce.
- Ultrafast: API 6.1 Sol a sei volte Standard per flussi particolarmente sensibili ai tempi.
Il supporto dipende dal modello. Il moltiplicatore del prezzo non indica quello della velocità; l'elaborazione regionale supportata può aggiungere un 10%. listino completo API
Piani ChatGPT e accesso ai modelli GPT-6
ChatGPT usa abbonamenti e quote; l'API viene fatturata soprattutto per token e livello di servizio. Plus non include automaticamente $20 mensili di credito API.
I prezzi seguenti sono mensili ufficiali in dollari; regione, imposte e addebito effettivo possono variare. La chat ordinaria e Work/Codex sono accessi distinti: i diritti di uno non dimostrano quelli dell'altro.
| Piano | Prezzo mensile | Accesso relativo a GPT-6 |
|---|---|---|
| Free | Gratuito | La chat passa gradualmente a 5.6 Luna; distribuzione separata di 6 Luna in Codex desktop |
| Go | $8 nella pagina ufficiale in dollari; verificare il prezzo locale | 5.6 Luna nella chat; distribuzione separata di 6 Luna in Codex desktop |
| Plus | $20 | GPT-6 Sol nella chat; Astra, 6.1 Sol e altri in Work/Codex |
| Pro 100 | $100 | GPT-6 Pro e quote di lavoro maggiori |
| Pro 200 | $200 | Quote superiori per GPT-6 Pro, Work e Codex |
| Pro 500 | $500 | Quota massima e accesso a Ultrafast |
Per Free e Go, 6 Luna su Codex desktop dipende ancora dal rilascio progressivo. Le fonti sono documentazione dei modelli Chat, pagina prezzi Work/Codex e dettagli dei piani Pro. Enterprise ed Education seguono regole proprie di accesso e consumo.
Quale modello usa GPT-6 nella chat?
Nei piani a pagamento idonei, selezionando GPT-6:
| Livello di ragionamento | Modello effettivo |
|---|---|
| Instant | GPT-6 Sol |
| Medium | GPT-6 Sol |
| High | GPT-6 Sol |
| Extra High | GPT-6 Sol |
| Pro | GPT-6 Pro basato su GPT-6 Astra |
Plus normalmente offre Instant, Medium e High, ma non Extra High e Pro nella chat. I piani superiori includono altri livelli: fa fede ciò che mostra l'account.
6.1 Sol non è attualmente un modello selezionabile a parte nella chat ordinaria. È destinato principalmente a Work, Codex e API. Non vederlo nella chat non implica che non sia disponibile negli altri accessi. GPT-6 Pro ha inoltre una quota indipendente: l'abbonamento Pro non rende Astra illimitato.
Ultrafast di Pro 500 non è un'accelerazione gratuita: consuma la quota inclusa a otto volte il tasso standard del modello. Esaurita la quota, l'uso di Credits viene addebitato a sei volte la tariffa Credit standard.
Prima dell'upgrade, chiarire se serve più volume, un modello più forte o meno latenza. Per approfondire: quote Codex e azzeramento e ChatGPT Go rispetto a Plus. documentazione dei modelli Chat · dettagli dei piani Pro
Quale GPT-6 scegliere per ogni attività?
Complessità e conseguenze degli errori sono criteri utili. La tabella segue la guida ufficiale alla scelta del modello ed è un punto di partenza per prove, non una configurazione garantita. La chat usa i livelli visibili nell'interfaccia; per Work/Codex e API consultare le rispettive impostazioni.
| Attività | Modello iniziale | Ragionamento |
|---|---|---|
| Classificazione, etichette, estrazione | GPT-6 Luna | None / Low |
| Assistenza frequente, testi semplici | GPT-6 Luna | Low / Medium |
| Conversazioni quotidiane in ChatGPT | GPT-6 Sol | Instant |
| Articoli lunghi, analisi ordinarie, discussione di proposte | GPT-6 Sol | Medium / High |
| Programmazione ordinaria, correzione bug | GPT-6.1 Sol | Medium |
| Refactoring su più file, revisioni complesse | GPT-6.1 Sol | High / XHigh |
| Grandi progetti, operazioni complesse al computer | GPT-6 Astra | Iniziare da Medium, poi High / Max se necessario |
| Ricerca difficile e ragionamento specialistico | GPT-6 Astra | Confrontare Medium con High / Max |
| Automazioni pianificate in massa | GPT-6 Luna, poi Sol se necessario | Low / Medium |
Aumentare il ragionamento può aggiungere verifiche interne, token e tempo. Per lavori semplici e definiti non garantisce risultati migliori e può ridurre l'efficienza.
Strategia 1: partire dal modello economico e salire se necessario
Il routing a livelli affida a Luna le attività ordinarie. Controlli falliti, informazioni incoerenti o lavori notoriamente multistadio passano a 6.1 Sol. La decisione deve basarsi su regole aziendali, verifiche degli output e controlli a campione, non solo sulla sicurezza dichiarata dal modello. Astra interviene per i casi veramente difficili o con errori costosi.
Un'assistenza clienti può usare Luna per classificare, Sol per analizzare controversie contrattuali e Astra per supportare la revisione dei pochi casi ad alto rischio; la decisione finale resta umana. Spesso costa meno che inviare tutto al modello di punta.
Strategia 2: misurare il costo del lavoro riuscito
La metrica utile è il costo totale per attività completata con successo. In forma semplificata:
Costo complessivo = chiamate al modello + strumenti + tentativi aggiuntivi + correzioni umane.
Se un modello economico richiede cinque tentativi e Astra uno solo, il secondo può costare meno nel complesso. Per il codice bisogna includere test superati, possibilità di integrare le modifiche, ampiezza ragionevole del diff e tempo di revisione.
Strategia 3: eseguire in modo asincrono i lavori lunghi
Scansioni di grandi repository, report settimanali, raccolte di documenti e analisi prolungate possono usare 6.1 Sol in background o in parallelo quando non serve una risposta immediata. Eseguire attività indipendenti riduce l'attesa umana, non automaticamente il costo totale.
Nei prodotti interattivi, Luna, un ragionamento inferiore o una classe di servizio più veloce possono offrire un'esperienza migliore.
Strategia 4: riutilizzare il contesto tramite cache
Mantenere stabili istruzioni di sistema, definizioni degli strumenti, descrizioni del repository e altri prefissi riutilizzabili può evitare lavoro ripetuto sul contesto statico. La lettura della cache di 6.1 Sol costa $0.10 per milione di token; verificare però i cache hit nel consumo reale: inviare di nuovo lo stesso testo non prova che sia tutto fatturato a tariffa cache.
Su molti turni il risparmio può essere rilevante. La cache non sostituisce una corretta gestione del contesto: informazioni vecchie o irrilevanti vanno rimosse.
Opinioni della community: qualità del codice, costi e velocità
Gli esempi seguenti sono rintracciabili nei post, soprattutto su Reddit e Hacker News. Non sono un campione casuale né rappresentano l'intera opinione online. Si notano apprezzamento per Astra accompagnato da critiche al consumo, delusione per 6 Sol rispetto a 5.6 e disponibilità ad accettare l'attesa di 6.1 Sol in cambio del risparmio.
1. Astra: valido nel lavoro professionale, non superiore ovunque
In r/singularity, imadade racconta che Astra affronta problemi per i quali altri modelli richiedevano ripetute indicazioni e chiede chiarimenti soprattutto quando mancano davvero informazioni. Apprezza il giudizio su questioni aziendali e teoriche e la comunicazione più concisa. Reddit: prime esperienze con Astra
Su Hacker News un utente confronta prompt identici e trova con Astra fonti più pertinenti e materiali didattici migliori rispetto a 5.6 Sol. Un altro elogia sintesi e linguaggio naturale, ma ritiene il servizio caro e facile da esaurire. Alcuni sviluppatori segnalano inoltre interruzioni nelle automazioni desktop, con necessità di chiedere più volte di proseguire.
Migliori capacità non garantiscono quindi un'esperienza migliore per tutti. Pianificazione, prompt, ambiente e gestione delle quote influiscono sul risultato. Hacker News: opinioni su Astra
2. Sol: perché alcuni preferiscono ancora 5.6
Jarr11 scrive in r/OpenAI che 6 Sol è meno completo e accurato nei lavori complessi rispetto a 5.6 Sol. Per lui resta un vuoto fra un Sol poco potente e un Astra troppo caro; alcuni commentatori tornano a 5.6. Reddit: 6 Sol è il successore di 5.6?
Sono impressioni d'uso, non prove controllate e complete. Ragionamento, permessi degli strumenti e ambiente possono cambiare molto i risultati. Il progresso nei benchmark non assicura lo stesso miglioramento in tutti i flussi esistenti.
3. 6.1 Sol: 24 attività reali di codice e costi inferiori
bisonbear2 ha trasformato 24 modifiche già integrate di un repository Go/TypeScript in compiti per 6 Sol e 6.1 Sol. Entrambi hanno eseguito una sola prova per compito con ragionamento Medium.
| Esito del confronto | GPT-6.1 Sol |
|---|---|
| Vince rispetto a GPT-6 Sol | 9 attività |
| Pareggio | 10 attività |
| Risultato inferiore a GPT-6 Sol | 5 attività |
Nella valutazione complessiva 6.1 Sol ha un piccolo vantaggio. Le cinque sconfitte sono confronti relativi, non cinque attività fallite: non permettono di calcolare il tasso di successo. Il costo tipico è circa la metà, grazie sia alla cache più economica sia a un uso spesso inferiore di token.
Le modifiche generate sono però più ampie e possono richiedere più revisione umana. I tempi sono simili: 6.1 Sol non risulta chiaramente più veloce. Il rapporto espone il metodo, ma usa un solo repository, 24 attività e una prova per coppia modello-compito. Il punteggio include un modello giudice; l'autore sviluppa anche lo strumento di valutazione Stet. Questi limiti impediscono generalizzazioni. Reddit: confronto su 24 attività di codice
4. Quanto è veloce 6.1 Sol? Un test della community
Hot_Season8992 ha pubblicato in r/codex un confronto nel quale tutti i modelli usano XHigh.
| Modello | Velocità Normal | Velocità Fast |
|---|---|---|
| GPT-5.6 Sol | 102.6 Token/s | 168.1 Token/s |
| GPT-6 Sol | 77.0 Token/s | 117.4 Token/s |
| GPT-6 Astra | 44.4 Token/s | 65.4 Token/s |
| GPT-6.1 Sol | 22.3 Token/s | 64.2 Token/s |
| GPT-6 Luna | 184.7 Token/s | 188.5 Token/s |
In questa prova 6.1 Sol Normal produce circa un quinto dei token al secondo di 5.6 Sol. Fast accelera molto 6.1 Sol, ma resta sotto 5.6 Sol Fast. Reddit: velocità di 6.1 Sol
Non sono garanzie ufficiali di throughput: sono misure di un singolo utente in un momento, ambiente e configurazione specifici. Account, carico e tipo di richiesta possono cambiare i risultati. Token/s non equivale inoltre al tempo totale: meno chiamate agli strumenti e tentativi possono consegnare prima il lavoro anche con output più lento.
Su Hacker News, conception considera il costo dell'attesa troppo alto e propone modelli più rapidi per parte del lavoro. Altri trovano accettabile il rapporto fra qualità e velocità senza usare il ragionamento massimo. Hacker News: discussione sulla latenza
5. La qualità continua a dividere
Upper-Animator-5067 ha chiesto a 6.1 Sol con Medium un minigioco nella giungla seguendo un flusso di sviluppo indicato. Secondo il resoconto mancavano funzioni importanti, il gioco non era realmente giocabile e anche ulteriori correzioni non hanno raggiunto l'obiettivo. Reddit: test deludente nello sviluppo di giochi
Impossible-Sand5012 riporta invece risultati affidabili e basso consumo di quota con più lavori paralleli a Max. È una testimonianza personale, senza registri completi di utilizzo utili a confronti omogenei. Reddit: lento ma efficiente
Manutenzione prolungata di repository, creazione di un gioco completo da zero e programmazione interattiva richiedono qualità differenti.
Quali conclusioni sono ragionevoli?
Alcuni utilizzatori riconoscono l'alto potenziale di Astra, soprattutto nel lavoro professionale e nelle operazioni complesse, senza dimostrare una superiorità netta in ogni compito rispetto a 5.6. Le critiche a 6 Sol mostrano che il prezzo ridotto non compensa certi problemi di qualità, ma non provano un peggioramento universale.
Nel rapporto sulle 24 attività, il vantaggio principale di 6.1 Sol è economico; il test separato di velocità ricorda di misurare la latenza nelle interazioni. I social hanno inoltre un forte bias: esperienze estreme vengono pubblicate più facilmente e spesso non si controllano livello di ragionamento, versione, carico e strumenti. Sono utili per individuare problemi da verificare, non per sostituire test sul proprio lavoro.
Come valutare GPT-6 nelle applicazioni reali?
Prima di integrarlo in produzione, conviene costruire un piccolo insieme di compiti reali, senza iniziare necessariamente da un benchmark complesso. Si possono campionare 30–50 attività recenti, includendo casi semplici, medi e difficili. È un suggerimento iniziale, non una garanzia di rappresentatività statistica.
Confrontare 6.1 Sol, Luna e Astra con descrizioni, dati e permessi identici. Registrare almeno:
- Successo: compito realmente completato e requisiti rispettati.
- Costo totale: input, output, cache, strumenti e tentativi.
- Tempo complessivo: dall'invio al risultato utilizzabile, non soltanto Token/s.
- Intervento umano: solleciti, correzioni e riparazioni necessarie.
La scelta deve seguire gli obiettivi aziendali, non il primo posto in classifica. Per lavori complessi partire da 6.1 Sol Medium e confrontare poi Low e High su costo e successo. Per funzioni frequenti e standardizzate provare prima Luna. Introdurre Astra quando i test reali mostrano il bisogno di capacità superiori. Così il compromesso fra qualità, velocità e budget resta sostenibile.
FAQ sui modelli GPT-6
Qual è il modello GPT-6 più potente?
OpenAI posiziona Astra per i lavori più difficili. La scelta dipende comunque da successo, durata e costo totale. Per programmazione complessa ordinaria provare 6.1 Sol; per classificazione ed estrazione Luna. Non ogni richiesta necessita del modello di punta.
GPT-6.1 Sol costa meno di GPT-6 Sol?
Input e output ordinari hanno lo stesso prezzo: $2 e $10 per milione di token. La lettura della cache scende da $0.20 a $0.10. Ragionamento, cache hit, strumenti e correzioni influenzano il conto: non è corretto parlare sempre di costo dimezzato.
ChatGPT Plus può usare GPT-6.1 Sol?
La descrizione ufficiale attuale include 6.1 Sol in ChatGPT Work e Codex per Plus. GPT-6 nella chat ordinaria segue una selezione diversa. L'accesso effettivo dipende anche da rollout, versione del client e autorizzazioni dell'account.
GPT-6.1 Sol è sempre più lento di 5.6 Sol?
Il test della community citato ha misurato meno Token/s nel proprio ambiente, senza stabilire una regola per tutte le richieste. Confrontare l'intera durata a parità di compito, ragionamento e modalità di servizio.
Chi usa GPT-5.6 dovrebbe passare interamente a GPT-6?
Mantenere prima 5.6 come riferimento e confrontare gli stessi compiti con i nuovi modelli. Sostituirlo quando qualità, costo o attesa giustificano la migrazione. Una sola applicazione può combinare Luna, Sol e Astra per attività differenti.
Fonti
- cronologia ufficiale delle uscite
- catalogo modelli OpenAI
- rapporto di lancio di Astra
- valutazione ufficiale di 6.1 Sol
- presentazione di Sol e Luna
- documentazione API di 6.1 Sol
- note sul prezzo di 5.6 Sol
- fatturazione dei token di ragionamento
- listino completo API
- documentazione dei modelli Chat
- pagina prezzi Work/Codex
- dettagli dei piani Pro
- guida ufficiale alla scelta del modello
- Reddit: prime esperienze con Astra
- Hacker News: opinioni su Astra
- Reddit: 6 Sol è il successore di 5.6?
- Reddit: confronto su 24 attività di codice
- Reddit: velocità di 6.1 Sol
- Hacker News: discussione sulla latenza
- Reddit: test deludente nello sviluppo di giochi
- Reddit: lento ma efficiente
Dati ufficiali e prezzi verificati il 16 ottobre 2026. Le cifre della community sono dichiarate dagli autori dei post e non sono state riprodotte indipendentemente.