GPT-6シリーズ比較:Astra、Sol、Luna、6.1 Solはどう選ぶ?
GPT-6シリーズにはAstra、Sol、Lunaと、更新版のGPT-6.1 Solがあります。 Codex、ChatGPT Work、APIで複雑な作業をするなら、まず6.1 Solを評価するとよいでしょう。大量の分類・情報抽出にはLuna、難しい推論や専門的な成果物にはAstraが候補です。通常のChatGPTチャットに表示される「GPT-6」は別のモデル対応になっており、6.1 Solと同一視できません。
OpenAIは2026年9月3日に最上位のAstra、9月22日にSolとLuna、9月29日に6.1 Solを発表し、用途と予算に応じた選択肢をそろえました。公式リリース履歴
GPT-5.6からの変化で注目したいのは、複雑な作業の実行能力、成功率、コストです。ただし実際の評価は分かれます。Astraの専門能力を高く評価する人がいる一方、6 Solのコード品質への不満や、6.1 Solの待ち時間への指摘もあります。
公式ベンチマーク、料金の計算例、出典を確認できるコミュニティの事例を通じて、選択に影響する違いを見ていきます。
情報確認日:2026年10月16日。料金は米ドル。公式評価、コミュニティの測定、本記事の提案を区別しています。
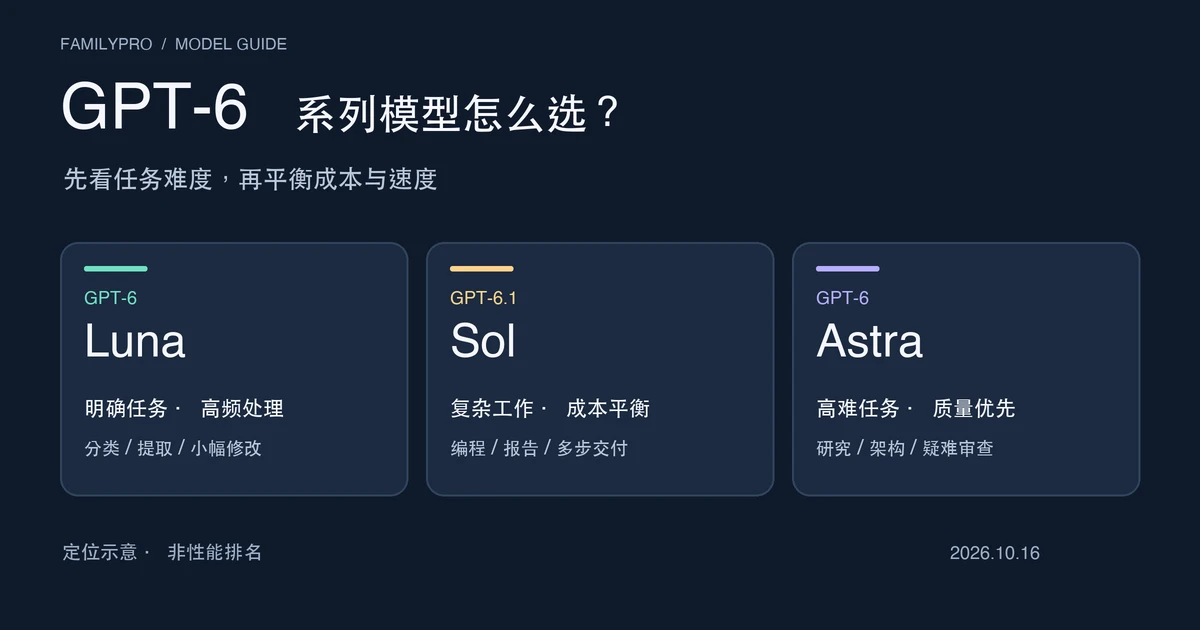
編集部が作成した位置付けの概念図です。製品画面やベンチマーク結果ではありません。
目次
- GPT-6シリーズのモデル一覧
- GPT-5.6からの性能向上
- 6.1 Solと6 Solの違い
- API料金とコスト計算
- ChatGPTのプランと利用可能モデル
- 用途別の選び方
- コミュニティの評価と速度測定
- よくある質問
GPT-6シリーズにはどんなモデルがある?
現在は四つのモデルを区別でき、Solには6と6.1の二つの版があります。
| モデル | 位置付け | 向いている作業 |
|---|---|---|
| GPT-6 Astra | 最上位の能力重視モデル | 難しい推論、研究、複雑なプログラミング、専門的な成果物 |
| GPT-6 Sol | 初期のバランス型モデル | プログラミング、ツール呼び出し、エージェントのワークフロー |
| GPT-6.1 Sol | 更新版のバランス型モデル | 複雑な開発、日常の専門業務、予算を抑えたいエージェント |
| GPT-6 Luna | 軽量で効率重視 | 大量処理、分類、情報抽出、頻繁に実行する自動化 |
中心となる三つの層は、品質を優先するAstra、Astraに近い能力と大幅なコスト削減の両立を目指す6.1 Sol、速度と低料金を重視するLunaです。
GPT-6 Solは6.1 Solの前の版で、APIから引き続き利用できますが、新規プロジェクトでは通常、6.1 Solから評価できます。
GPT-5.6にはSol、Terra、Lunaという三つの層がありましたが、正式なGPT-6 Terraは現在ありません。6.1 Solが新世代の中間層を担っています。最新の位置付けはOpenAIのモデル一覧で確認できます。
GPT-6 Astra:最上位の汎用モデル
OpenAIによると、Astraは現在、総合能力が最も高い汎用モデルで、深い推論と高品質な結果が必要な複雑な作業を対象としています。大規模コードベースの分析、複雑な事業レポート、専門ソフトの操作、科学的推論、長時間にわたる多段階のコンピューター操作などが例です。
長い処理でのツール利用と成果物の完成度を重視していますが、実際の結果はアプリ側のツールと権限にも左右されます。料金も他のGPT-6モデルより高く、あらゆる用途に適するわけではありません。
GPT-6 Sol:最初のコストバランス型
Solは最上位モデルの能力の一部を低価格帯に提供し、開発、専門業務、エージェントの実行を主な対象とします。標準APIの入力・出力単価はいずれもAstraの5分の1です。
ただし評価は大きく分かれました。5.6 Solを長く使ってきた開発者の一部は、安くなった一方で、複雑な作業の完成度や実行の安定性が低下したと感じています。
GPT-6.1 Sol:複雑な作業の能力とコストを調整
6.1 Solは6 Solの1週間後に登場しました。Astraより大幅に低い料金で、複雑な作業においてAstraに近い能力を提供するという位置付けです。前のSolから、ソフトウェア開発、文書理解、コンピューター操作、事実の正確性が重点的に改善されています。
コミュニティでは「Astra Lite」と呼ばれることもありますが、正式名称ではありません。引用した公式説明では基盤となるアーキテクチャの関係は明らかにされておらず、Astraの圧縮版だとは断定できません。
GPT-6 Luna:低コストで処理を担うモデル
Lunaはシリーズで最も安く、高速な処理を重視します。問い合わせの分類、構造化データの抽出、簡単なコード修正、情報の絞り込み、定型的な自動化など、大量に発生する目的の明確な作業に適しています。
メールが返金依頼か苦情かを判別するために、最先端の数学的推論能力が必要とは限りません。こうした頻度が高く難易度の低い処理が、Lunaの主な用途です。
GPT-6 vs GPT-5.6:性能は何が向上した?
公式データでは、主な改善は複雑な作業とツールの実行に集中しています。すべての作業が同じ割合で向上したわけではありません。
1. プログラミング:複雑な開発課題で改善
以下はAstraの発表レポートからの抜粋です。発表時点の結果であり、各モデルについて異なる推論強度で得られた最高点を採用しています。同じ推論設定での比較ではありません。 研究環境やAPIで評価しており、製品版ChatGPTと結果が異なる可能性があります。本記事では再測定していません。
| ベンチマーク | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4.0 | 37.3% | 57.9% |
| DeepSWE v1.1 | 72.7% | 74.1% |
| FrontierCode 1.1 Main(スコア) | 47.5 | 53.3 |
| データベース移行課題(社内) | 42.7% | 63.9% |
Terminal-Benchでは20.6ポイント向上した一方、DeepSWEの差は1.4ポイントです。すべての開発作業でGPT-6が5.6を大幅に上回るとはいえません。 評価ごとの伸びは大きく異なり、複雑なターミナル作業を優先して試す根拠にはなりますが、二つの数値だけですべての開発作業を「改善が大きい・小さい」に分類することはできません。
開発者にとっては、コードの生成速度より、リポジトリを理解し、テストを実行し、マージ可能な変更を提出できるかが重要な場合があります。
2. Computer Use:回答からコンピューター操作へ
コンピューター操作も主要な改善点です。下表はAstraの発表レポートと同じ条件で、OSWorldはv2026.08.08のオフラインセット、ScreenSpot-Proはツールなしの設定です。
| ベンチマーク | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| OSWorld 2.0(オフライン、部分点方式) | 65.7% | 72.6% |
| ScreenSpot-Pro | 76.9% | 92.7% |
| AutomationBench | 18.1% | 41.4% |
OSWorldはPCで実際の作業を実行する能力、ScreenSpot-Proは画面上の対象を見つける能力、AutomationBenchは複数ツールをまたぐ業務フローの遂行を評価します。
公式のOSWorld遅延シミュレーションでは、5.6 Solは1課題あたり約75分で65.7%、Astraは約40分で72.6%でした。これは部分点方式で、課題を完全に成功させた割合と直接同一視できません。
評価スコアを上げながら、シミュレーション上の完了時間を約47%短縮したことになります。ただし特定の評価環境での結果であり、実際の作業すべてが同程度に速くなるとは限りません。
3. 研究:難しい推論の能力が向上
Terminal-Bench Science 0.1では5.6 Solが22.4%、Astraが64.6%、FrontierMath Tier 4(v2)では83.0%と97.6%でした。
これらはAstraの初回発表レポートの数値で、後のレポートでは更新された結果を使う可能性があります。対応する評価での進歩を示すもので、研究全般の改善率には換算できません。
試験やベンチマークで高得点を取っても、研究者の科学的判断をそのまま代替できるわけではありません。手法、データ、実験、結論の独立した検証が必要です。
4. 事実の正確性と実行時の安全性
OpenAIは、意図的に難しく構成した事実性評価で、6 Solの事実誤りが前世代のおよそ半分になったと報告しています。6.1 Solはさらに改善し、低い推論強度での難問評価では、事実誤りを含む回答が11.4%から7.7%に減りました。
相対的には約32%減、差は3.7ポイントです。どちらの発表も、ユーザーが以前に誤りを指摘した難しい会話を基にしたサンプルであり、普段の利用における誤答率ではないと説明しています。6.1 Solの事実性評価
もう一つは権限の範囲の理解です。Astraは複雑なエージェント作業で、許可されていない追加操作、誤解を招く実行報告、目的からの逸脱を減らし、承認された範囲をより正確に守るよう重点的に訓練されています。
ファイル、ブラウザー、外部システムを操作するエージェントには、作業を完了する能力に加え、独断で実行してはいけない操作を理解することも求められます。
5. 長時間の作業におけるコンテキスト管理
AstraのCodex環境には、実験的なコンテキスト保持の仕組みも導入されました。従来の要約による圧縮では重要な細部が失われる場合があります。
発表レポートでは、作業メモを保持し、過去のコンテキストウィンドウの内容を検索する試験的な方式が説明されています。長期のデバッグや大きなリファクタリングで情報の喪失を減らす狙いですが、利用可否や有効化の方法は最新のクライアント資料で確認してください。初回発表の説明が、すべての環境の既定動作とは限りません。
シリーズのプロンプトキャッシュも改善され、繰り返し使うコンテキストを再利用しやすくなりました。同じコードベース、業務資料、システムプロンプトを何度も読む企業向けエージェントでは、費用の削減につながる可能性があります。
参考:GPT-6 Astraの発表・評価レポート · GPT-6 SolとLunaの発表
GPT-6.1 Solとは?6 Solと何が違う?
Astraが能力の上限を担うとすれば、6.1 Solはコスト効率を改めて最適化したモデルです。
一部の評価でAstraに近い能力、標準単価は5分の1
ソフトウェア開発、文書分析、PC操作の一部の評価では、6.1 Solは大幅に低い課題あたり費用でAstraに近い結果を出しています。
DeepSWE v1.1では、より低い推論強度とコストで6 Solの最高点を6.4ポイント上回り、Astraの約5分の1の課題あたり費用でAstraと同等の結果になったと報告されています。
OSWorld 2.0のオフラインセットをMaxで評価した場合、Astraとの差は2.1ポイント以内、課題あたり費用は約7分の1でした。
「Astraに近い」は、すべての作業が最上位の水準という意味ではありません。最も難しい研究には引き続きAstraが推奨されています。この差と費用は6.1 Solの発表時評価における特定の推論設定の結果であり、あらゆる作業に固定の比率が当てはまるわけではありません。
キャッシュ読み取り単価は6 Solの半分
標準APIの入力・出力単価は6 Solと同じで、100万トークンあたり入力$2、出力$10です。変わったのはキャッシュ入力で、6 Solの$0.20から6.1 Solでは$0.10に下がりました。
単発の小さな質問では差が小さくても、同じリポジトリ、ツール定義、作業履歴を繰り返し読む継続的な開発エージェントでは、キャッシュできる部分の節約が積み重なります。一部の複雑な課題ではトークン使用量自体も少ないため、実際の課題あたり費用が前の版より大幅に安くなる可能性があります。
低コストでも低遅延とは限らない
多くの開発者が必要とするのは、毎回最高性能を呼び出すことより、多くの作業を妥当な費用でこなし、長く動かしても予算を急速に使い切らないモデルです。6.1 Solはその需要を狙っています。
ただし、低コストと低遅延は別です。 生成速度はサービスモード、推論強度、負荷に左右され、5.6 Solより明らかに遅いと感じた開発者もいます。
自分の評価でも待ち時間が長いなら、バックグラウンドで実行できる複雑な仕事に回し、リアルタイムの対話では遅延を別途測ってください。API単価だけでは選べません。
6.1 Solはnoneとminimalに対応せず、最低はlowです。簡単な作業にはnoneに対応するLunaも比較できます。6.1 Solでツールを使う場合はResponses APIが必要で、旧アプリのモデルIDを書き換えるだけでは移行完了になりません。6.1 SolのAPI資料
GPT-6のAPI料金と計算例
以下は公式のStandard料金です。単位は100万トークンあたりの米ドルで、1リクエストの入力が272Kトークン以下の通常テキスト料金に適用されます。
| モデル | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
| GPT-5.6 Sol | $4.00 | $0.40 | $20.00 |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 |
| GPT-6 Sol | $2.00 | $0.20 | $10.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
Astraの標準入力・出力単価は5.6 Solの2.5倍です。一方、6 Solと6.1 Solはともに5.6 Solの半分です。同じ通常入力・出力トークン数なら、Lunaの費用はAstraの100分の1で、大規模かつ検証しやすい処理で先に評価する価値があります。
5.6 Solは現在プロモーション料金で、公式には少なくとも2026年11月21日まで続くとされています。その後は再確認が必要です。5.6 Solの料金説明
単価と、作業を一つ完了する総費用は異なります。 高性能なモデルが、少ないトークン、ツール呼び出し、再試行で完了する場合もあります。
月間利用の計算例
カスタマーサポートの自動化で月1,000件を処理し、1件平均が入力2,000トークン、課金対象の出力500トークン(推論分を含む)と仮定します。合計は入力200万、出力50万トークンです。
以下は使用量を固定した計算例であり、実測平均ではありません。キャッシュ、ツール料金、再試行、追加サービス料金は含めていません。
| モデル | 理論上の月額API費用 |
|---|---|
| GPT-6 Astra | $45.00 |
| GPT-6.1 Sol | $9.00 |
| GPT-6 Luna | $0.45 |
6.1 Solなら、200万÷100万×$2と50万÷100万×$10の合計で$9です。この例ではAstraはLunaの100倍になります。
内部の推論トークンも出力単価で課金されます。「出力500」が最終回答だけを意味するなら、思考に使う分を加算する必要があります。推論トークンの課金
問い合わせ種別の判定、注文番号の抽出、JSON出力だけなら、まずLunaで要件を満たせるか検証できます。複雑な契約紛争、苦情の証拠分析、多段階の業務判断なら、強いモデルによって誤りの手直しに必要な人件費を減らせる可能性があります。
見落としやすい課金条件
主なGPT-6モデルのコンテキストは約105万トークン、最大出力は128Kです。この容量は5.6 Solにもあり、6だけの改善ではありません。
入力が1リクエストあたり272Kを超えると長文料金になり、入力とキャッシュ関連料金は標準の2倍、出力は1.5倍です。リクエスト全体に適用されます。
キャッシュの読み取りと書き込みも別です。6.1 Solの読み取りは100万トークン$0.10ですが、標準の書き込みは$2.50です。
処理レベルにも違いがあります。
- Batch / Flex: 通常はStandardより50%安いものの、スループット、待ち行列、遅延のトレードオフがあります。
- Fast: 通常はStandardの2倍の料金で、より速いサービスを利用します。
- Ultrafast: 6.1 Sol APIではStandardの6倍で、速度要件の厳しい処理向けです。
各モデルで利用できるレベルはAPI資料を確認してください。料金倍率は速度倍率ではなく、対応する地域処理では10%の追加料金がかかる場合もあります。
公式料金表:OpenAI API Pricing
ChatGPTの月額料金とGPT-6の利用範囲
ChatGPTのサブスクリプションはプランと利用枠で管理され、APIは主にトークン数とサービスレベルに応じた従量課金です。 Plusを買っても毎月$20のAPI残高が付くわけではありません。
以下は個人向けの整理です。通常のChatとWork/Codexは別の入口で、一方の権利から他方を推測できません。 料金は公式の米ドル月額で、地域、税、実際の請求により異なる場合があります。
| プラン | 月額 | GPT-6関連の利用 |
|---|---|---|
| Free | 無料 | 通常Chatは順次5.6 Lunaへ。Codexデスクトップには別途6 Lunaを展開 |
| Go | 米ドル公式ページは$8、地域料金は別途確認 | 通常Chatは5.6 Luna。Codexデスクトップには別途6 Lunaを展開 |
| Plus | $20 | GPT-6 Solのチャット。Work/CodexではAstra、6.1 Solなど |
| Pro 100 | $100 | GPT-6 Proを含み、業務用の利用枠を拡大 |
| Pro 200 | $200 | GPT-6 Pro、Work、Codexでより大きい枠 |
| Pro 500 | $500 | 最大の利用枠とUltrafast利用権 |
FreeとGoのCodexデスクトップ向け6 Lunaは、展開状況にも左右されます。根拠はChatモデルの説明、Work/Codexの料金ページ、Proの各段階の説明です。企業・教育向けは独自の権限と利用枠が適用されます。
ChatGPTに表示される名前とAPIのモデル名は、必ずしも一対一ではありません。
通常のChatでいうGPT-6はどのモデル?
対象の有料チャットプランでGPT-6を選ぶ場合の対応は次の通りです。
| 思考レベル | 実際のモデル |
|---|---|
| Instant | GPT-6 Sol |
| Medium | GPT-6 Sol |
| High | GPT-6 Sol |
| Extra High | GPT-6 Sol |
| Pro | GPT-6 Astraを基盤とするGPT-6 Pro |
選べるレベルはプランごとに異なります。Plusは通常Instant、Medium、Highを利用でき、Extra HighとProのチャットレベルは含みません。Proなどの上位プランでは高いレベルも利用できますが、アカウント表示を確認してください。
6.1 Solは現在、通常のChatで単独選択するモデルではありません。 主にWork、Codex、API向けなので、通常Chatに表示されなくてもWorkやCodexで使えないとは限りません。
GPT-6 Proには独立した利用枠があり、Pro契約でもAstraが無制限になるわけではありません。Pro 500のUltrafastも追加消費のない加速ではなく、プラン内の枠は対象モデルの標準消費率の8倍で減り、枠の後にCreditsを使う場合は標準Credit料金の6倍で課金されます。
上位プランを買う前に、必要なのが処理件数、モデルの能力、低遅延のどれなのかを整理しましょう。計量期間とリセットはCodexの利用枠とリセット、入門プランはChatGPT GoとPlusの比較も参考になります。
参考:ChatGPTのGPT-6モデル案内 · Proプランの説明
用途別にGPT-6モデルを選ぶ
作業の複雑さと誤りの代償を基準にします。下表は公式の選択ガイドを参考にした試用の出発点で、結果を保証する設定ではありません。通常Chatは画面の思考レベルを使い、Work/CodexとAPIの設定範囲はそれぞれの資料で確認してください。
| 用途 | 推奨モデル | 推論強度 |
|---|---|---|
| 分類、タグ付け、情報抽出 | GPT-6 Luna | None / Low |
| 頻繁な問い合わせ対応、簡単なテキスト処理 | GPT-6 Luna | Low / Medium |
| 通常ChatGPTの日常会話 | GPT-6 Sol | Instant |
| 長文、一般的な分析、企画相談 | GPT-6 Sol | Medium / High |
| 日常的な開発、バグ修正 | GPT-6.1 Sol | Medium |
| 複数ファイルのリファクタリング、複雑なレビュー | GPT-6.1 Sol | High / XHigh |
| 大規模開発、複雑なPC操作 | GPT-6 Astra | Mediumから開始し、必要ならHigh / Max |
| 高難度の研究、専門的推論 | GPT-6 Astra | MediumとHigh / Maxを比較 |
| 定期的な大量自動処理 | GPT-6 Luna、必要に応じSol | Low / Medium |
推論強度は高ければよいとは限りません。内部推論や確認が増えると、トークンと総処理時間も増える可能性があります。範囲が明確な簡単な作業では、品質が上がらず効率だけが下がる場合もあります。
安いモデルから始め、必要な場合に上げる
段階的なルーティングでは、通常処理をLunaに任せます。ルール検証で失敗したもの、情報が矛盾するもの、多段階推論が必要と分かっているものを6.1 Solに送ります。判断には業務ルール、出力チェック、抜き取り検査を使い、モデルが自己申告する自信だけに頼らないでください。
本当に難しい、または失敗の代償が大きい場合だけAstraに上げます。問い合わせをLunaで分類し、契約紛争をSolで分析し、少数の高リスク案件をAstraで補助レビューして、最後は人が判断する、といった構成です。全件を最上位モデルに送るより費用を抑えやすくなります。
単価より「成功した作業あたりの総費用」
総費用は、モデル利用料+ツール料金+再試行費用+人による修正費用と考えられます。安いモデルで5回やり直す仕事をAstraが1回で完了するなら、単価が高くても総額は高いとは限りません。
開発ではテストの合否、マージ可能性、変更範囲の妥当性、人のレビュー時間も含めて評価します。
時間のかかる仕事を非同期で進める
コードベースの走査、週報、資料の一括整理、長期分析など即答が不要な処理には、6.1 Solの非同期・並列実行を検討できます。独立した作業をバックグラウンドで進めると人の待ち時間を減らせますが、総料金が自動的に下がるわけではありません。
リアルタイム操作で待ち時間が体験を損なう場合は、速いLuna、低い推論強度、高速サービスレベルが適する場合があります。
コンテキストキャッシュを再利用する
各ターンで静的コンテキストを組み直す代わりに、システムプロンプト、ツール定義、リポジトリ説明などのキャッシュ可能な接頭部分を安定させます。
6.1 Solのキャッシュ読み取りは100万トークン$0.10ですが、ヒット状況は実際の使用量で確認してください。同じ内容を送っただけで全量がキャッシュ料金になるとは限りません。長い多段階処理では高いヒット率による節約が積み重なりますが、正確なコンテキスト管理も必要で、古い情報や不要な情報は整理すべきです。
GPT-6の評判:コード品質、費用、速度の議論
RedditやHacker Newsなどでは多くの議論があります。ここで紹介するのは原投稿を確認できる事例で、無作為抽出ではなく、ネット全体の意見を代表しません。
Astraの複雑な作業への能力を評価しつつ消費量に不満を持つ人、6 Solより5.6 Solを好む人、6.1 Solの節約効果のためなら長い待ち時間を受け入れる人がいます。 以下は具体的な利用経験や方法を説明した公開事例です。
1. Astra:専門業務では好評、日常体験は全面的な向上とは限らない
r/singularityのimadadeは、以前のモデルでは繰り返し誘導が必要だった問題をAstraが処理でき、追加質問も本当に情報が必要なときに限られると感じたと述べています。事業上の仕事や理論的な問題での判断力、簡潔な伝え方を評価しています。
Hacker Newsにも似た声があります。同じプロンプトで5.6 Solと比べ、関連性の高い出典や良い学習資料を見つけたというユーザー、情報統合と自然な文章を評価しながら高額で枠を使い切りやすいとするユーザーがいました。デスクトップ自動化で途中停止が多く、再開を何度も促す必要があったという報告もあります。
能力の進歩が全員の体験向上に直結するわけではなく、計画、プロンプト、実行環境、枠の管理も結果を左右します。
2. Sol:5.6より使いにくいと感じる理由
r/OpenAIのJarr11は、6 Solが複雑な課題の完成度や細かさで5.6 Solに劣ると述べました。6 Solでは能力が足りずAstraは高すぎるため、製品構成に空白があると感じており、5.6 Solに戻ったとするコメントもあります。
Reddit:6 Solは5.6 Solの理想的な後継なのか
ただし利用者の感想であり、条件を統制した全面的な評価ではありません。推論設定、ツール権限、実行環境でも差が出ます。示唆は、公式ベンチマークが向上しても、既存のすべてのワークフローが同じように改善するとは限らないという点です。
3. 6.1 Sol:実際の開発24課題で品質を保ち費用を削減
bisonbear2はGoとTypeScriptの混合リポジトリで、マージ済みの24件の変更を課題にし、6 Solと6.1 SolをMediumでそれぞれ1回ずつ実行しました。
| 比較結果 | GPT-6.1 Sol |
|---|---|
| GPT-6 Solより良い | 9件 |
| 同等 | 10件 |
| GPT-6 Solより劣る | 5件 |
総合評価では6.1 Solが少し優位でした。「5件で劣る」は個別比較の勝敗であり、テストに失敗した課題が5件という意味ではなく、成功率の計算にも使えません。
典型的な課題あたり費用は約半分で、キャッシュ入力が安いだけでなく、使うトークンも少ない傾向でした。一方、変更するコードの範囲は大きく、人がレビューする量が増える可能性があります。所要時間の差は大きくなく、6.1 Solが明らかに速かったわけではありません。
方法は公開されていますが、単一リポジトリの24課題で各1回という限界があります。総合評価にはモデルによる判定も含み、投稿者は評価ツールStetの開発者でもあります。すべての開発用途へ一般化できません。
4. 6.1 Solの速度:コミュニティの測定例
r/codexのHot_Season8992は、全モデルをXHighにした環境で生成速度を測定しました。
| モデル | Normalの生成速度 | Fastの生成速度 |
|---|---|---|
| GPT-5.6 Sol | 102.6 Token/s | 168.1 Token/s |
| GPT-6 Sol | 77.0 Token/s | 117.4 Token/s |
| GPT-6 Astra | 44.4 Token/s | 65.4 Token/s |
| GPT-6.1 Sol | 22.3 Token/s | 64.2 Token/s |
| GPT-6 Luna | 184.7 Token/s | 188.5 Token/s |
この測定では6.1 SolのNormalは5.6 Solの約5分の1でした。Fastで6.1 Sol自体は大きく速くなりましたが、5.6 SolのFastよりは遅い結果でした。
Reddit:6.1 Solは5.6 Solより4.6倍遅いのか
公式のスループット保証ではありません。特定の時刻・環境・設定での個人の測定であり、アカウント、負荷、リクエストによって変わります。また生成速度は作業全体の完了速度とは異なり、ツール利用や再試行が少なければ、結果を早く届けられる可能性があります。
Hacker Newsのconceptionは待ち時間のコストが高すぎ、一部を速いモデルに任せる価値があると述べました。一方、最高の推論強度を使わなければ、速度と品質のバランスを許容できるという声もあります。
5. 仕上がりへの評価も分かれる
Upper-Animator-5067は指定した開発ワークフローを参照させ、Mediumの6.1 Solにジャングル風のミニゲームを作らせました。しかし重要な機能が欠け、普通に遊べる状態にならず、問題を伝えて修正を求めても目標を達成しなかったと報告しています。
逆にImpossible-Sand5012はMaxで複数の仕事を並列実行し、利用枠の消費が少なく結果も信頼できると評価しました。ただし個人の感想で、横断比較に使える完全な使用記録は示されていません。
大規模リポジトリの長期保守、ゼロからのゲーム制作、即応が必要な対話的プログラミングでは、良いモデルの条件が異なります。
これらの議論から読み取れること
第一に、Astraの能力の高さは専門業務や複雑な操作で一部の利用者に認められていますが、すべての課題で5.6を大きく超えるとは限りません。
第二に、6 Solへの不満は、一部のワークフローでは安さが品質低下を補えないことを示しますが、全員にとって退化したとは断定できません。
第三に、24課題の報告では6.1 Solの主な利点は費用でした。他のユーザーの速度測定は、リアルタイム用途では遅延も別に検証すべきことを示します。
第四に、SNSのサンプルには偏りがあります。特に良い・悪い体験をした人ほど投稿しやすく、推論レベル、版、負荷、ツール設定を統制していない例も多いためです。議論は懸念を見つける材料になっても、自分の実作業での評価の代わりにはなりません。
開発チームはどう評価すればよい?
本番導入の前に、少量の実際の作業を集めましょう。最初から複雑なベンチマークを作る必要はありません。最近の30〜50件から簡単・中程度・難しい課題を選ぶ方法があります。ただし開始の目安であり、統計的な代表性を保証する件数ではありません。
同じ説明、データ、ツール権限で6.1 Sol、Luna、Astraを比べ、少なくとも次を記録します。
- 成功率: 実際に完了し、要件を満たしたか。
- 総費用: 入出力、キャッシュ、ツール、再試行の実額。
- 完了時間: Token/sだけでなく、依頼から利用可能な成果までの時間。
- 人の介入: 再指示、修正、モデルが起こした問題の復旧が必要だったか。
順位ではなく事業の目的に合うモデルを選びます。複雑な作業は6.1 SolのMediumから試し、LowとHighでも費用と成功率の変化を比較できます。頻繁で定型的な処理はLunaから、実測で能力不足が分かった課題にAstraを導入すると、品質、速度、予算を両立しやすくなります。
GPT-6のよくある質問(FAQ)
GPT-6で最も高性能なモデルは?
公式にはAstraが最も難しい仕事向けです。ただし成功率、時間、総費用も考慮してください。一般的な複雑な開発は6.1 Sol、大量の抽出・分類はLunaから試せます。毎回最上位を使う必要はありません。
GPT-6.1 Solは6 Solより安い?
通常入力・出力は同じで100万トークン$2と$10です。キャッシュ読み取りは$0.20から$0.10になりました。実額は推論量、ヒット率、ツール、やり直しにも左右され、一律に半額とはいえません。
PlusでGPT-6.1 Solを使える?
現在の公式説明ではPlusのWorkとCodexで利用できます。通常ChatのGPT-6は別の選択体系です。入口の表示は展開状況、クライアントの版、アカウント権限にも左右されます。
6.1 Solは必ず5.6 Solより遅い?
引用した個人測定では低いToken/sでしたが、すべてのリクエストの速度を保証するものではありません。同じ課題、推論強度、サービスモードで、出力速度だけでなく全体の完了時間を比較してください。
5.6からすべてGPT-6へ移行すべき?
まず5.6を対照として残し、同じ課題で新モデルを比較しましょう。品質、費用、待ち時間が移行に見合って改善した場合に置き換えます。一つのアプリでLuna、Sol、Astraを使い分ける方法もあります。
参考資料
- 公式リリース履歴
- OpenAIモデル一覧
- Astra発表レポート
- 6.1 Sol事実性評価
- SolとLunaの発表
- 6.1 Sol API資料
- 5.6 Solの料金
- 推論トークン課金
- OpenAI API Pricing
- Chatモデルの説明
- Work/Codex料金
- Proプランの説明
- モデル選択ガイド
- Astra初期体験
- Hacker NewsのAstra評価
- 6 Solと5.6 Solの比較
- 実際の開発24課題
- 6.1 Solの速度測定
- Hacker Newsの速度議論
- ゲーム開発の事例
- 6.1 Solへの肯定的評価
公式データと料金の確認日:2026年10月16日。コミュニティの数値は投稿者の報告であり、本記事では独立した再測定をしていません。