GPT-6 시리즈 비교: Astra, Sol, Luna, 6.1 Sol은 어떻게 선택할까?
GPT-6 시리즈에는 Astra, Sol, Luna와 업데이트된 GPT-6.1 Sol이 있습니다. Codex, ChatGPT Work, API에서 복잡한 업무를 처리한다면 6.1 Sol부터 평가해 볼 수 있습니다. 대량 분류·정보 추출은 Luna, 고난도 추론과 전문 결과물은 Astra가 후보입니다. 일반 ChatGPT 채팅의 'GPT-6'은 별도의 모델 대응 관계를 사용하므로 6.1 Sol과 동일하게 볼 수 없습니다.
OpenAI는 2026년 9월 3일 최상위 Astra, 9월 22일 Sol과 Luna, 9월 29일 6.1 Sol을 발표해 작업과 예산에 따른 제품군을 구성했습니다. 공식 출시 이력
GPT-5.6 대비 주목할 부분은 복잡한 작업의 실행 능력, 성공률, 비용입니다. 실제 평가는 엇갈립니다. Astra의 전문성을 인정하는 사용자가 있는 반면, 6 Sol의 코드 품질에 불만을 느끼거나 6.1 Sol의 긴 대기 시간을 지적하는 사용자도 있습니다.
공식 벤치마크, 비용 계산 예시, 원문을 확인할 수 있는 커뮤니티 사례를 통해 선택에 영향을 주는 차이를 살펴봅니다.
정보 확인일: 2026년 10월 16일. 가격 단위는 미국 달러입니다. 공식 평가, 커뮤니티 측정, 이 글의 제안을 구분했습니다.
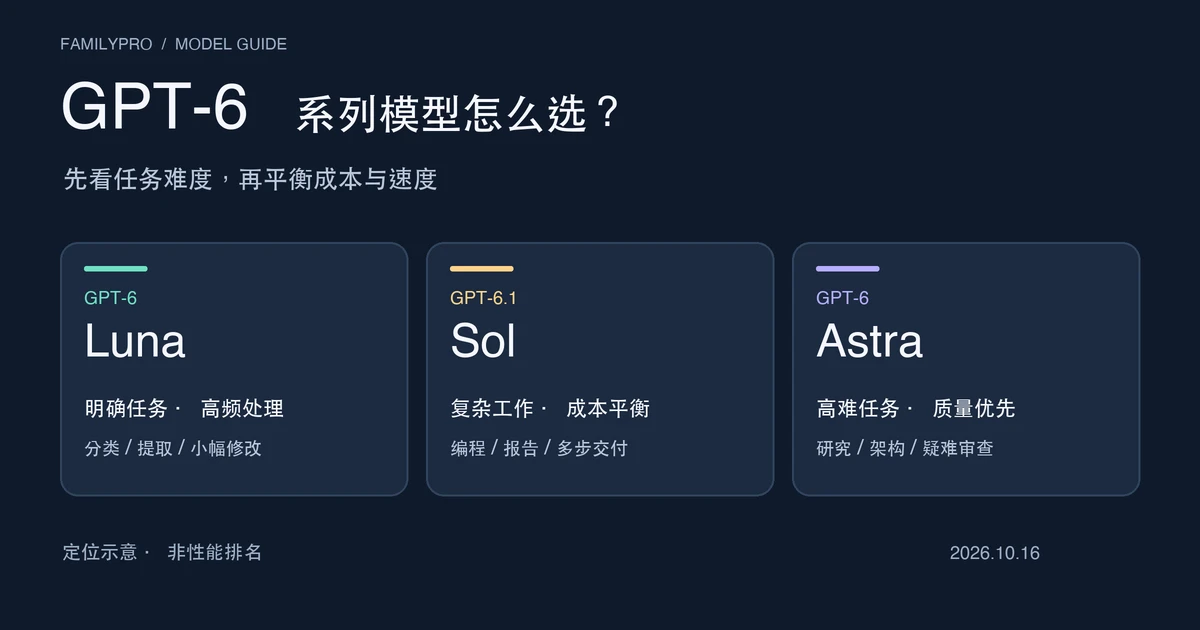
편집 과정에서 제작한 모델 포지셔닝 개념도입니다. 제품 화면이나 벤치마크 결과가 아닙니다.
빠른 탐색
- GPT-6 모델 종류
- GPT-5.6 대비 성능 변화
- 6.1 Sol과 6 Sol의 차이
- API 가격과 비용 계산
- ChatGPT 요금제와 모델 이용 범위
- 작업별 모델 선택
- 커뮤니티 평가와 속도 측정
- 자주 묻는 질문
GPT-6 시리즈에는 어떤 모델이 있나?
현재 네 가지 모델을 구분할 수 있으며, Sol에는 6과 6.1 두 버전이 있습니다.
| 모델 | 포지셔닝 | 적합한 작업 |
|---|---|---|
| GPT-6 Astra | 최상위 성능 중심 | 고난도 추론, 연구, 복잡한 개발, 전문 결과물 |
| GPT-6 Sol | 초기 균형형 | 개발, 도구 호출, 에이전트 워크플로 |
| GPT-6.1 Sol | 개선된 균형형 | 복잡한 개발, 일상 전문 업무, 예산에 민감한 에이전트 |
| GPT-6 Luna | 경량·효율 중심 | 대량 처리, 분류, 정보 추출, 빈번한 자동화 |
주요 세 계층은 작업 품질을 우선하는 Astra, Astra에 가까운 능력과 큰 비용 절감을 함께 목표로 하는 6.1 Sol, 처리 속도와 저렴한 비용을 우선하는 Luna입니다.
GPT-6 Sol은 6.1 Sol의 이전 버전입니다. API로 계속 접근할 수 있지만 새 프로젝트라면 보통 6.1 Sol부터 평가할 수 있습니다.
GPT-5.6에는 Sol, Terra, Luna 세 계층이 있었지만, 현재 정식 GPT-6 Terra 모델은 없습니다. 6.1 Sol이 새 세대의 중간 계층 역할을 맡습니다. 최신 포지셔닝은 OpenAI 모델 목록에서 확인할 수 있습니다.
GPT-6 Astra: 최상위 범용 모델
OpenAI의 공식 설명에 따르면 Astra는 현재 종합 능력이 가장 높은 범용 모델로, 깊은 추론과 높은 완성도가 필요한 복잡한 업무를 대상으로 합니다. 대규모 코드베이스 분석, 복잡한 비즈니스 보고서, 전문 소프트웨어 조작, 과학적 추론, 장시간에 걸친 다단계 컴퓨터 작업 등이 예입니다.
긴 작업 흐름에서 도구 활용과 결과물의 완결성을 중시하지만, 실제 효과는 애플리케이션이 제공하는 도구와 권한에도 좌우됩니다. 다른 GPT-6 모델보다 사용 비용도 훨씬 높아 모든 상황에 적합하지는 않습니다.
GPT-6 Sol: 초기 비용 균형형
Sol은 최상위 능력 일부를 더 낮은 가격대로 제공하며 개발, 전문 업무, 에이전트 실행을 주로 겨냥합니다. 표준 API 입력·출력 단가는 각각 Astra의 5분의 1입니다.
출시 후 평가는 상당히 갈렸습니다. 5.6 Sol을 오래 사용한 개발자 일부는 가격이 낮아졌지만 복잡한 작업의 완결성과 실행 안정성은 후퇴했다고 느꼈습니다.
GPT-6.1 Sol: 복잡한 업무 능력과 비용의 균형
6.1 Sol은 6 Sol 출시 일주일 뒤 공개됐습니다. Astra보다 훨씬 낮은 비용으로 복잡한 작업에서 Astra에 가까운 능력을 제공한다는 방향입니다. 이전 Sol 대비 소프트웨어 개발, 문서 이해, 컴퓨터 조작, 사실 정확성을 중점적으로 개선했습니다.
커뮤니티에서 'Astra Lite'라고 부르기도 하지만 공식 모델명은 아닙니다. 인용한 공식 설명에는 두 모델의 기반 아키텍처 관계가 공개되지 않았으므로 Astra의 압축 버전이라고 단정할 수 없습니다.
GPT-6 Luna: 저비용 실행의 주력
Luna는 시리즈에서 가장 저렴하고 빠른 처리를 지향합니다. 고객 문의 분류, 구조화 데이터 추출, 간단한 코드 수정, 정보 필터링, 정기 자동화처럼 목표가 명확하고 반복되는 작업에 활용할 수 있습니다.
이메일이 환불 요청인지 불만인지 구별하는 데 최고 수준의 수학 추론 능력이 항상 필요한 것은 아닙니다. 이렇게 빈도가 높고 난도가 낮은 처리가 Luna의 주된 용도입니다.
GPT-6 vs GPT-5.6: 무엇이 개선됐나?
공식 데이터에서 주요 향상은 복잡한 업무와 도구 실행에 집중됩니다. 모든 작업이 같은 비율로 좋아진 것은 아닙니다.
1. 개발 능력: 복잡한 엔지니어링 과제에서 개선
다음은 Astra 출시 보고서의 일부입니다. 해당 보고서 시점의 결과이며, 각 모델이 서로 다른 추론 강도에서 얻은 최고 점수를 사용합니다. 동일한 추론 설정의 비교가 아닙니다. 연구 환경 또는 API로 평가했으므로 실제 ChatGPT 제품과 다를 수 있습니다. 이 글은 독립적으로 재실행하지 않았습니다.
| 벤치마크 | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4.0 | 37.3% | 57.9% |
| DeepSWE v1.1 | 72.7% | 74.1% |
| FrontierCode 1.1 Main(점수) | 47.5 | 53.3 |
| 데이터베이스 마이그레이션(내부 과제) | 42.7% | 63.9% |
Terminal-Bench에서는 20.6%p 향상됐지만 DeepSWE 차이는 1.4%p입니다. GPT-6가 모든 코드 작업에서 5.6보다 훨씬 강하다고 볼 수는 없습니다. 평가별 개선 폭이 크게 다릅니다. 복잡한 터미널 작업에서 업그레이드 효과를 먼저 검증할 근거는 되지만, 두 점수만으로 모든 개발 작업을 '큰 개선'과 '작은 개선'으로 나눌 수는 없습니다.
개발자에게는 코드 생성 속도보다 저장소를 이해하고, 테스트를 실행하며, 병합 가능한 변경을 제출하는 능력이 더 중요할 수 있습니다.
2. Computer Use: 답변에서 컴퓨터 조작으로
컴퓨터 조작도 핵심 개선 방향입니다. 아래는 Astra 보고서와 같은 조건으로, OSWorld는 v2026.08.08 오프라인 세트, ScreenSpot-Pro는 도구 없는 설정입니다.
| 벤치마크 | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| OSWorld 2.0(오프라인, 부분 점수) | 65.7% | 72.6% |
| ScreenSpot-Pro | 76.9% | 92.7% |
| AutomationBench | 18.1% | 41.4% |
OSWorld는 컴퓨터로 실제 과제를 수행하는 능력, ScreenSpot-Pro는 화면에서 시각적 대상을 찾는 능력, AutomationBench는 여러 도구에 걸친 업무 흐름의 완수를 측정합니다.
공식 OSWorld 지연 시뮬레이션에서 5.6 Sol은 과제당 약 75분에 65.7%, Astra는 약 40분에 72.6%였습니다. 부분 점수 방식이므로 이 수치를 과제를 완전히 성공한 비율로 직접 해석하면 안 됩니다.
평가 점수를 높이면서 시뮬레이션 완료 시간을 약 47% 줄인 결과입니다. 특정 환경에서의 측정이므로 현실의 모든 작업에서 비슷한 속도 향상을 보장하지는 않습니다.
3. 연구: 복잡한 추론 능력 향상
Terminal-Bench Science 0.1에서 5.6 Sol은 22.4%, Astra는 64.6%였습니다. FrontierMath Tier 4(v2)는 각각 83.0%, 97.6%입니다.
이는 Astra 최초 발표 보고서의 결과이며 후속 보고서는 업데이트된 수치를 사용할 수 있습니다. 해당 평가에서의 진전을 보여주지만 모든 연구 과제의 개선 폭으로 환산할 수는 없습니다.
시험이나 벤치마크에서 높은 점수를 받았다고 연구자의 과학적 판단을 그대로 대체할 수 있는 것은 아닙니다. 실제 연구에서는 방법, 데이터, 실험, 결론을 독립적으로 검증해야 합니다.
4. 사실 정확성과 실행 안전성
OpenAI는 별도로 구성한 고난도 사실성 평가에서 6 Sol의 사실 오류 수가 이전 세대의 약 절반이었다고 밝혔습니다. 6.1 Sol은 이를 더 개선해, 낮은 추론 강도의 어려운 문제 평가에서 사실 오류를 포함한 응답 비율을 11.4%에서 7.7%로 낮췄습니다.
상대 감소율은 약 32%, 차이는 3.7%p입니다. 두 발표 모두 사용자가 과거 모델 오류를 표시했던 어려운 대화에서 표본을 구성했으며, 일상 사용의 오류율을 뜻하지 않는다고 설명합니다. 6.1 Sol 사실성 평가
작업 경계의 이해도 변화입니다. Astra는 복잡한 에이전트 작업에서 승인 범위를 더 정확히 따르고, 허가 없는 추가 조작, 오해를 유발하는 실행 보고, 목표 이탈을 줄이도록 중점 훈련됐습니다.
파일, 브라우저, 외부 시스템을 조작하는 모델은 일을 끝낼 능력뿐 아니라 임의로 실행하면 안 되는 작업도 알아야 합니다.
5. 장시간 작업의 컨텍스트 관리
Astra의 Codex 환경에는 실험적인 컨텍스트 보존 방식도 도입됐습니다. 기존 긴 대화에서는 요약 압축으로 이전 정보를 남기지만 핵심 세부 사항이 사라질 수 있습니다.
출시 보고서는 작업 메모를 유지하고 이전 컨텍스트 창의 내용을 검색하는 실험적 방식을 소개합니다. 장기 디버깅과 대규모 리팩터링의 정보 손실을 줄이려는 목적입니다. 이용 여부와 활성화 방법은 현재 클라이언트 문서를 확인해야 하며, 출시 당시 설명을 모든 환경의 기본 동작으로 볼 수는 없습니다.
시리즈의 프롬프트 캐시도 개선돼 반복 컨텍스트의 재사용 효율을 높였습니다. 같은 코드베이스, 업무 자료, 시스템 프롬프트를 자주 읽는 기업용 에이전트에서는 직접적인 비용 절감으로 이어질 수 있습니다.
참고: GPT-6 Astra 공식 발표·평가 · GPT-6 Sol과 Luna 발표
GPT-6.1 Sol은 무엇이며 6 Sol과 어떻게 다른가?
Astra가 능력의 상한을 맡는다면 6.1 Sol은 비용 효율을 다시 최적화한 모델입니다.
일부 평가에서 Astra에 근접, 표준 단가는 5분의 1
소프트웨어 개발, 문서 분석, 컴퓨터 조작의 일부 테스트에서 6.1 Sol은 훨씬 낮은 과제당 비용으로 Astra에 가까운 결과를 냈습니다.
DeepSWE v1.1에서는 더 낮은 추론 강도와 비용으로 6 Sol의 최고 점수보다 6.4%p 높았고, Astra의 약 5분의 1의 과제 비용으로 Astra와 비슷한 점수를 달성했다고 보고됐습니다.
OSWorld 2.0 오프라인 세트의 Max 설정에서는 Astra와의 차이가 2.1%p 이내였고 과제당 비용은 약 7분의 1이었습니다.
'Astra에 근접'이 모든 작업에서 최상위 수준이라는 의미는 아닙니다. 가장 어려운 연구에는 여전히 Astra가 권장됩니다. 이 차이와 과제 비용은 6.1 Sol 출시 평가의 특정 추론 설정에 해당하며 모든 작업에 고정 적용되는 비율이 아닙니다.
캐시 읽기 단가는 6 Sol의 절반
표준 API 입력·출력은 6 Sol과 동일하게 100만 토큰당 $2, $10입니다. 바뀐 부분은 캐시 입력으로, 6 Sol의 $0.20에서 6.1 Sol은 $0.10으로 낮아졌습니다.
한 번의 짧은 질문에서는 차이가 작을 수 있습니다. 하지만 저장소, 도구 정의, 작업 이력을 반복해서 읽는 지속형 개발 에이전트는 캐시 가능한 부분의 절감 효과가 누적됩니다. 일부 복잡한 작업에서는 토큰도 덜 사용하므로 실제 과제당 비용이 이전 버전보다 훨씬 낮을 수 있습니다.
낮은 비용과 짧은 지연은 별개
개발자가 매번 세계 최고 성능을 필요로 하지는 않습니다. 대부분의 일을 합리적인 호출 비용으로 처리하고 장기 실행에서도 예산을 급격히 소모하지 않는 모델이 필요할 때가 많습니다. 6.1 Sol은 이런 수요를 겨냥합니다.
다만 낮은 비용이 낮은 지연을 뜻하지는 않습니다. 생성 속도는 서비스 모드, 추론 강도, 부하에 좌우되며 일부 개발자는 5.6 Sol보다 확연히 느리다고 느꼈습니다.
자체 평가에서도 대기가 길다면 백그라운드 실행이 가능한 복잡한 업무에 먼저 적용하고, 실시간 상호작용은 지연을 별도로 측정하세요. API 단가만으로 선택하면 안 됩니다.
6.1 Sol은 none과 minimal을 지원하지 않으며 최소는 low입니다. 간단한 작업은 none을 지원하는 Luna와 비교할 수 있습니다. 6.1 Sol에서 도구 호출을 쓰려면 Responses API를 사용해야 하므로 기존 앱의 모델 ID만 교체했다고 마이그레이션이 끝나는 것은 아닙니다. 6.1 Sol API 문서
GPT-6 API 가격과 비용 계산
다음은 공식 Standard 처리 가격입니다. 단위는 100만 토큰당 미국 달러이며, 요청당 입력이 272K 토큰 이하인 일반 텍스트 요금 구간에 적용됩니다.
| 모델 | 입력 | 캐시 입력 | 출력 |
|---|---|---|---|
| GPT-5.6 Sol | $4.00 | $0.40 | $20.00 |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 |
| GPT-6 Sol | $2.00 | $0.20 | $10.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
Astra의 표준 입력·출력 단가는 5.6 Sol의 2.5배입니다. 6 Sol과 6.1 Sol은 모두 5.6 Sol의 절반입니다. 일반 입력·출력 토큰 수가 같다면 Luna 비용은 Astra의 100분의 1이므로 규모가 크고 검증하기 쉬운 처리에 먼저 평가할 만합니다.
5.6 Sol은 현재 프로모션 가격이며 공식적으로 최소 2026년 11월 21일까지 지속됩니다. 이후에는 다시 확인해야 합니다. 5.6 Sol 가격 설명
단가와 작업 하나를 완수하는 총비용은 다릅니다. 더 강한 모델이 더 적은 토큰, 도구 호출, 재시도로 끝낼 수도 있습니다.
월간 비용 예시
고객 지원 자동화가 월 1,000건을 처리하고, 건당 평균 입력 2,000토큰과 과금 대상 출력 500토큰(추론 토큰 포함)을 사용한다고 가정합니다. 월 합계는 입력 200만, 출력 50만 토큰입니다.
아래는 고정 사용량 계산이며 실측 평균 비용이 아닙니다. 캐시, 도구 호출료, 재시도, 추가 서비스 비용은 제외했습니다.
| 모델 | 이론상 월 API 비용 |
|---|---|
| GPT-6 Astra | $45.00 |
| GPT-6.1 Sol | $9.00 |
| GPT-6 Luna | $0.45 |
6.1 Sol은 200만÷100만×$2와 50만÷100만×$10을 합해 월 $9입니다. 이 예에서 Astra 비용은 Luna의 100배입니다.
내부 추론 토큰도 출력 요율로 청구됩니다. '출력 500'이 최종적으로 보이는 답변만 뜻한다면 사고 과정의 사용량도 더해야 합니다. 추론 토큰 과금 설명
문의 유형 판별, 주문번호 추출, JSON 출력만 필요하다면 Luna가 기준을 충족하는지 먼저 검증할 수 있습니다. 복잡한 계약 분쟁, 불만 증거 분석, 다단계 업무 판단이라면 강한 모델이 오류로 인한 사람의 처리 비용을 줄일 수 있습니다.
놓치기 쉬운 과금 조건
주요 GPT-6 모델은 약 105만 토큰의 컨텍스트 창과 최대 128K 출력을 지원합니다. 이 용량은 이미 5.6 Sol에도 있어 6 시리즈만의 개선은 아닙니다.
한 요청의 입력이 272K를 넘으면 긴 컨텍스트 요율을 적용해 입력과 캐시 관련 요율은 표준의 2배, 출력은 1.5배가 되며 요청 전체에 적용됩니다.
캐시 읽기와 쓰기도 다릅니다. 6.1 Sol의 읽기는 100만 토큰당 $0.10이지만 표준 쓰기는 $2.50입니다.
API 처리 등급도 구분됩니다.
- Batch / Flex: 보통 Standard보다 50% 저렴하지만 처리량, 대기열, 지연 측면의 절충이 있습니다.
- Fast: 보통 Standard의 2배 비용으로 더 빠른 서비스를 제공합니다.
- Ultrafast: 6.1 Sol API에서는 Standard의 6배로, 속도 요건이 높은 작업 흐름에 적합합니다.
모델별 지원 등급은 API 문서를 확인해야 합니다. 요금 배수가 작업 속도 배수는 아니며, 지원되는 지역 처리에는 10%가 추가될 수도 있습니다.
전체 가격: OpenAI API Pricing
ChatGPT 구독 가격과 GPT-6 이용 범위
ChatGPT 구독은 요금제와 사용 한도로 관리되고, API는 주로 토큰과 서비스 등급에 따른 종량제입니다. Plus를 구독해도 매달 $20의 API 토큰 잔액을 받는 것은 아닙니다.
개인 요금제는 다음처럼 정리할 수 있습니다. 일반 Chat과 Work/Codex는 서로 다른 진입점이므로 한쪽의 혜택으로 다른 쪽을 추정할 수 없습니다. 아래는 공식 미국 달러 월 요금이며 지역, 세금, 실제 계정 청구는 다를 수 있습니다.
| 요금제 | 월 요금 | GPT-6 관련 이용 |
|---|---|---|
| Free | 무료 | 일반 Chat은 순차적으로 5.6 Luna로 전환, Codex 데스크톱에는 별도로 6 Luna 배포 |
| Go | 공식 달러 페이지 $8, 지역 가격 별도 확인 | 일반 Chat은 5.6 Luna, Codex 데스크톱에는 별도로 6 Luna 배포 |
| Plus | $20 | GPT-6 Sol 채팅, Work/Codex에서 Astra·6.1 Sol 등 이용 |
| Pro 100 | $100 | GPT-6 Pro 포함, 업무 사용 한도 확대 |
| Pro 200 | $200 | GPT-6 Pro·Work·Codex의 더 높은 한도 |
| Pro 500 | $500 | 최상위 사용량, Ultrafast 권한 포함 |
Free·Go의 Codex 데스크톱용 6 Luna는 배포 진행 상황에도 좌우됩니다. 근거는 Chat 모델 설명, Work/Codex 가격 페이지, Pro 등급 설명입니다. 기업·교육용은 자체 권한과 한도 규칙을 적용합니다.
ChatGPT 화면의 모델명과 API 모델명은 항상 일대일로 대응하지 않습니다.
일반 Chat의 GPT-6는 실제로 어떤 모델인가?
해당 유료 채팅 요금제에서 GPT-6를 선택하면 다음처럼 대응합니다.
| 사고 수준 | 실제 모델 |
|---|---|
| Instant | GPT-6 Sol |
| Medium | GPT-6 Sol |
| High | GPT-6 Sol |
| Extra High | GPT-6 Sol |
| Pro | GPT-6 Astra 기반 GPT-6 Pro |
선택 가능한 수준은 요금제마다 다릅니다. Plus는 보통 Instant, Medium, High를 이용할 수 있지만 Extra High와 Pro 채팅 수준은 포함하지 않습니다. Pro 등 상위 요금제는 더 높은 수준을 포함하며 실제 계정 표시를 확인해야 합니다.
6.1 Sol은 현재 일반 Chat에서 별도로 선택하는 모델이 아닙니다. 주로 Work, Codex, API에 제공됩니다. 일반 채팅에 보이지 않아도 Work나 Codex에서 이용할 수 없다는 뜻은 아닙니다.
GPT-6 Pro에는 별도 사용 한도가 있어 Pro 구독이 Astra 무제한을 뜻하지 않습니다. Pro 500의 Ultrafast도 추가 소모 없는 가속은 아닙니다. 요금제 내 한도에서는 해당 모델 표준 소모율의 8배로 차감하고, 한도 이후 Credits를 쓰면 표준 Credit 요율의 6배로 청구합니다.
상위 요금제를 구매하기 전에 필요한 것이 더 많은 작업량인지, 더 강한 모델인지, 짧은 지연인지 판단하세요. 측정 구간과 초기화는 Codex 한도와 초기화 안내, 입문 요금제는 ChatGPT Go와 Plus 비교를 참고할 수 있습니다.
참고: ChatGPT GPT-6 모델 안내 · Pro 요금제 설명
작업별 GPT-6 모델 선택 방법
작업 복잡도와 오류의 대가를 기준으로 고릅니다. 표는 공식 모델 선택 가이드를 참고한 시험 출발점이며 효과를 보장하는 설정이 아닙니다. 일반 Chat은 화면의 사고 수준을 사용하고, Work/Codex·API의 설정 범위는 각 문서를 확인하세요.
| 작업 | 권장 모델 | 추론 강도 |
|---|---|---|
| 분류, 태그, 정보 추출 | GPT-6 Luna | None / Low |
| 고빈도 고객 지원, 간단한 텍스트 처리 | GPT-6 Luna | Low / Medium |
| 일반 ChatGPT 일상 대화 | GPT-6 Sol | Instant |
| 긴 글, 일반 분석, 기획 논의 | GPT-6 Sol | Medium / High |
| 일반 개발, 버그 수정 | GPT-6.1 Sol | Medium |
| 다중 파일 리팩터링, 복잡한 코드 리뷰 | GPT-6.1 Sol | High / XHigh |
| 대규모 개발, 복잡한 컴퓨터 조작 | GPT-6 Astra | Medium부터, 필요하면 High / Max |
| 고난도 연구·전문 추론 | GPT-6 Astra | Medium과 High / Max 비교 |
| 예약된 대량 자동화 | GPT-6 Luna, 필요하면 Sol로 상향 | Low / Medium |
추론 강도는 높을수록 좋은 것이 아닙니다. 내부 추론과 검증이 많아지면 토큰과 총처리 시간이 늘 수 있습니다. 경계가 명확한 단순 작업에서는 결과가 개선되지 않고 효율만 낮아질 수도 있습니다.
저렴한 모델부터 시작하고 복잡한 경우 상향
계층형 라우팅에서는 Luna가 일반 작업을 처리합니다. 규칙 검증 실패, 정보 충돌, 다단계 추론이 필요하다고 알려진 작업은 6.1 Sol에 맡깁니다. 상향 판단은 업무 규칙, 출력 검사, 표본 검수에 기반해야 하며 모델이 스스로 보고하는 자신감에만 의존하면 안 됩니다.
정말 어렵거나 실패 비용이 큰 경우에만 Astra로 올립니다. 예를 들어 Luna로 고객 문의를 분류하고, 계약 분쟁은 Sol로 분석하며, 소수의 고위험 건은 Astra가 검토를 돕고 최종 결정은 사람이 할 수 있습니다. 모든 요청을 최상위 모델에 보내는 것보다 비용을 절감하기 쉽습니다.
단가 대신 성공한 작업당 총비용 비교
실용적인 지표는 성공적으로 완료한 작업 한 건의 총비용입니다. 모델 호출료 + 도구 비용 + 재시도 비용 + 사람의 수정 비용으로 볼 수 있습니다.
저렴한 모델이 다섯 번 재시도하는 일을 Astra가 한 번에 끝낸다면 단가는 비싸도 총액은 더 높지 않을 수 있습니다. 개발에서는 테스트 통과, 병합 가능성, 적절한 수정 범위, 사람의 리뷰 시간도 함께 계산해야 합니다.
오래 걸리는 일은 비동기로 실행
저장소 스캔, 주간 보고서, 자료 일괄 정리, 장기 분석처럼 즉시 응답이 필요하지 않은 일에는 6.1 Sol의 비동기·병렬 실행을 고려할 수 있습니다. 독립된 작업을 백그라운드로 돌리면 사람이 기다리는 시간은 줄지만 총비용이 자동으로 감소하지는 않습니다.
사용자가 제품을 실시간 조작하고 매번 대기가 경험을 해친다면 더 빠른 Luna, 낮은 추론 강도, 빠른 서비스 등급이 적합할 수 있습니다.
컨텍스트 캐시 재사용
매번 정적 컨텍스트 전체를 재구성하는 대신 시스템 프롬프트, 도구 정의, 저장소 설명 등 캐시 가능한 접두 부분을 안정적으로 유지할 수 있습니다.
6.1 Sol의 읽기는 100만 토큰당 $0.10이지만 적중 여부는 실제 사용량에서 확인해야 합니다. 같은 내용을 다시 보냈다고 모두 캐시 요율이라고 가정하면 안 됩니다. 장기 다중 턴 실행에서는 적중률에 따른 절감이 누적되지만 정확한 컨텍스트 관리도 필요하며 오래되거나 무관한 정보는 정리해야 합니다.
GPT-6 커뮤니티 평가: 코드 품질·비용·속도 논쟁
Reddit, Hacker News 등에는 많은 논의가 있습니다. 이 절은 원문을 추적할 수 있는 사례를 골랐으며 무작위 표본이나 인터넷 전체 여론을 대표하지 않습니다.
Astra의 복잡한 작업 능력을 인정하면서 소모량에는 불만을 느끼는 사람, 6 Sol보다 5.6 Sol이 낫다는 사람, 6.1 Sol의 비용 개선을 위해 긴 대기를 받아들이는 사람이 있습니다. 다음은 구체적인 사용 경험이나 측정 방법이 있는 공개 사례입니다.
1. Astra: 전문 작업에는 호평, 일상 경험이 항상 앞서지는 않는다
r/singularity의 imadade는 이전 모델을 반복해서 유도해야 했던 문제를 Astra가 처리하며, 실제로 정보가 더 필요할 때만 질문하는 편이라고 평가했습니다. 비즈니스와 이론 문제의 판단력, 더 간결한 소통을 높게 봤습니다.
Hacker News에도 비슷한 반응이 있습니다. 같은 프롬프트로 5.6 Sol과 비교해 더 관련성 높은 출처와 좋은 학습 자료를 찾았다는 사용자, 정보 종합과 자연스러운 표현을 칭찬하면서도 비싸고 한도를 빨리 소모한다고 본 사용자가 있었습니다. 데스크톱 자동화 중 자주 멈춰 여러 번 계속하라고 요청해야 했다는 보고도 있습니다.
성능 향상이 모든 사람의 경험 개선으로 바로 이어지는 것은 아닙니다. 계획, 프롬프트, 실행 환경, 한도 관리도 결과에 영향을 줍니다.
2. Sol: 왜 일부 사용자는 5.6을 더 선호할까?
r/OpenAI의 Jarr11은 6 Sol이 복잡한 작업의 완결성과 세밀함에서 5.6 Sol보다 약하다고 느꼈습니다. 6 Sol은 충분히 강하지 않고 Astra는 너무 비싸 제품군에 공백이 있다고 보았으며, 일부 댓글 작성자는 5.6 Sol로 돌아갔다고 밝혔습니다.
Reddit: 6 Sol은 5.6 Sol의 이상적인 후속 모델인가
이는 실제 사용자의 인상이지 조건을 통제한 전면적 성능 시험은 아닙니다. 추론 설정, 도구 권한, 실행 환경으로 큰 차이가 날 수 있습니다. 다만 공식 벤치마크의 향상이 기존 모든 워크플로의 동일한 개선을 보장하지는 않는다는 점을 보여줍니다.
3. 6.1 Sol: 실제 코드 작업 24건에서 품질 유지와 비용 절감
bisonbear2는 Go·TypeScript 혼합 저장소에서 이미 병합된 실제 변경 24건을 과제로 만들고, 두 모델을 Medium에서 과제마다 한 번씩 실행했습니다.
| 비교 결과 | GPT-6.1 Sol |
|---|---|
| GPT-6 Sol보다 우수 | 9건 |
| 동률 | 10건 |
| GPT-6 Sol보다 낮음 | 5건 |
종합 평점에서는 6.1 Sol이 약간 앞섰습니다. '5건에서 낮음'은 개별 비교의 승패이며 테스트 실패가 5건이라는 뜻이 아니고, 이를 이용해 성공률을 계산할 수도 없습니다.
전형적인 작업 비용은 약 절반이었습니다. 캐시 입력이 저렴할 뿐 아니라 토큰도 적게 쓰는 경향이 있었습니다. 다만 코드 변경 범위가 더 커 사람이 검토할 양이 늘 수 있습니다. 소요 시간 차이는 크지 않아 6.1 Sol이 확실히 빠르지는 않았습니다.
평가 방법은 공개됐지만 저장소 하나의 24개 과제이고 모델당 각 한 번뿐입니다. 종합 평가에는 모델 심판도 포함하며 작성자는 평가 도구 Stet의 개발자입니다. 이 조건을 고려해야 하며 모든 개발 환경으로 일반화할 수 없습니다.
4. 6.1 Sol 속도는? 커뮤니티 측정 예시
r/codex의 Hot_Season8992는 모든 모델을 XHigh로 설정한 환경에서 생성 속도를 측정했습니다.
| 모델 | Normal 생성 속도 | Fast 생성 속도 |
|---|---|---|
| GPT-5.6 Sol | 102.6 Token/s | 168.1 Token/s |
| GPT-6 Sol | 77.0 Token/s | 117.4 Token/s |
| GPT-6 Astra | 44.4 Token/s | 65.4 Token/s |
| GPT-6.1 Sol | 22.3 Token/s | 64.2 Token/s |
| GPT-6 Luna | 184.7 Token/s | 188.5 Token/s |
이 측정에서 6.1 Sol의 Normal 출력 속도는 5.6 Sol의 약 5분의 1이었습니다. Fast로 바꾸면 자체 속도는 크게 개선됐지만 5.6 Sol의 Fast보다는 느렸습니다.
Reddit: 6.1 Sol은 5.6 Sol보다 4.6배 느린가
공식 처리량 보장은 아닙니다. 특정 시점·환경·설정의 개인 측정이며 계정, 부하, 요청 유형에 따라 달라집니다. 토큰 생성 속도와 작업 완료 속도도 다릅니다. 도구 호출이나 재시도가 적으면 전체 결과는 더 빨리 나올 수 있습니다.
Hacker News의 conception은 대기 비용이 너무 커 일부를 더 빠른 모델에 맡길 가치가 있다고 봤습니다. 반면 최고 추론 강도를 쓰지 않으면 속도와 품질의 균형을 받아들일 수 있다는 개발자도 있습니다.
5. 결과물 품질도 의견이 갈린다
Upper-Animator-5067은 지정한 개발 워크플로를 참고하게 하고 Medium의 6.1 Sol에 정글 테마 미니게임을 만들도록 요청했습니다. 중요한 기능이 누락되고 정상적으로 플레이할 수준에 못 미쳤으며 문제를 알려 수정하도록 해도 목표를 달성하지 못했다고 보고했습니다.
반대로 Impossible-Sand5012는 Max로 여러 작업을 병렬 실행하며 한도 소모가 적고 결과가 신뢰할 만하다고 평가했습니다. 개인적 경험이며 비교에 활용할 수 있는 완전한 사용량 기록은 제시하지 않았습니다.
Reddit: 느리지만 6.1 Sol을 긍정적으로 평가한 사례
대형 저장소의 장기 유지보수, 처음부터 완전한 미니게임 만들기, 실시간 대화형 개발에서는 '좋은 모델'의 기준이 다릅니다.
커뮤니티 논의에서 얻을 수 있는 판단
첫째, Astra의 높은 능력은 전문 업무와 복잡한 조작에서 일부 사용자에게 인정받지만 모든 과제에서 5.6보다 크게 우수한 것은 아닙니다.
둘째, 6 Sol에 대한 불만은 일부 워크플로에서 낮은 단가가 품질 하락을 상쇄하지 못함을 보여주지만 모든 사용자에게 퇴보했다고 단정할 수 없습니다.
셋째, 24건 보고서에서 6.1 Sol의 주된 이익은 비용이었습니다. 다른 사용자의 속도 측정은 실시간 용도에서는 지연을 별도로 검증해야 함을 알려줍니다.
넷째, 소셜 미디어 표본은 편향됩니다. 특히 좋거나 나쁜 경험을 한 사람이 글을 쓰기 쉽고, 추론 수준, 버전, 서비스 부하, 도구 설정을 통제하지 않은 시험이 많습니다. 논의는 주의할 문제를 발견하기에 좋지만 자체 작업 부하에서의 검증을 대체하지 않습니다.
개발자는 실제 효과를 어떻게 평가할까?
실서비스 도입 전 소규모 실제 작업 세트를 만드는 편이 합리적입니다. 처음부터 복잡한 AI 벤치마크를 만들 필요는 없습니다. 최근 작업 30~50건에서 단순·중간·고난도 과제를 뽑을 수 있습니다. 이 수는 시작을 위한 권장치일 뿐 통계적 대표성을 보장하지 않습니다.
같은 작업 설명, 데이터, 도구 권한으로 6.1 Sol, Luna, Astra를 비교하고 적어도 다음을 기록하세요.
- 성공률: 실제 완료 여부와 요구사항 충족 여부.
- 총비용: 입출력, 캐시, 도구, 재시도의 실제 지출.
- 완료 시간: Token/s만이 아니라 제출부터 쓸 수 있는 결과까지의 시간.
- 사람의 개입: 반복 지시, 결과 수정, 모델이 만든 문제의 복구 필요 여부.
순위 자체보다 사업 목표에 맞는 모델을 골라야 합니다. 복잡한 작업은 6.1 Sol의 Medium부터 시험한 뒤 Low와 High에서 비용·성공률이 어떻게 바뀌는지 비교할 수 있습니다. 빈번하고 표준화된 기능은 Luna부터, 실제 평가에서 높은 능력이 필요하다고 드러난 경우에 Astra를 도입하면 품질·속도·예산의 지속 가능한 균형을 잡기 쉽습니다.
GPT-6 자주 묻는 질문(FAQ)
GPT-6 중 가장 강한 모델은?
공식적으로 Astra가 가장 어려운 작업을 대상으로 합니다. 그래도 성공률, 시간, 총비용을 함께 고려해야 합니다. 일반적인 복잡한 개발은 6.1 Sol, 대량 추출·분류는 Luna부터 시험할 수 있으며 매번 최상위 모델을 호출할 필요는 없습니다.
6.1 Sol은 6 Sol보다 저렴한가?
일반 입력·출력 단가는 100만 토큰당 $2와 $10으로 같습니다. 캐시 읽기는 $0.20에서 $0.10으로 내려갔습니다. 실제 비용은 추론량, 캐시 적중, 도구, 재작업에도 좌우되므로 일률적으로 반값이라고 할 수 없습니다.
Plus에서 6.1 Sol을 쓸 수 있나?
현재 공식 설명은 Plus의 Work와 Codex 이용을 명시합니다. 일반 Chat의 GPT-6는 다른 선택 체계입니다. 실제 진입점은 배포 상황, 클라이언트 버전, 계정 권한에도 영향을 받습니다.
6.1 Sol은 항상 5.6 Sol보다 느린가?
인용한 커뮤니티 측정은 해당 환경에서 낮은 Token/s를 관찰했지만 모든 요청에 대한 속도 보장이 아닙니다. 같은 작업, 추론 강도, 서비스 모드에서 출력 처리량뿐 아니라 전체 완료 시간을 비교해야 합니다.
5.6에서 전부 GPT-6로 옮겨야 하나?
먼저 5.6을 대조군으로 유지하고 같은 과제로 새 모델을 비교하세요. 품질, 비용, 대기 시간이 이전할 만큼 개선될 때 교체하면 됩니다. 한 앱에서 Luna, Sol, Astra를 동시에 사용해 역할을 나눌 수도 있습니다.
참고 자료
- 공식 출시 이력
- OpenAI 모델 목록
- Astra 출시 보고서
- 6.1 Sol 사실성 평가
- Sol·Luna 발표
- 6.1 Sol API 문서
- 5.6 Sol 가격
- 추론 토큰 과금
- OpenAI API Pricing
- Chat 모델 설명
- Work/Codex 가격
- Pro 요금제 설명
- 모델 선택 가이드
- Astra 초기 경험
- Hacker News의 Astra 평가
- 6 Sol과 5.6 Sol 비교
- 실제 코드 작업 24건
- 6.1 Sol 속도 측정
- Hacker News 속도 논쟁
- 게임 개발 사례
- 6.1 Sol 긍정 평가
공식 데이터와 가격 확인일: 2026년 10월 16일. 커뮤니티 수치는 원문 작성자의 보고이며 독립적으로 재실행하지 않았습니다.