Модели GPT-6: как выбрать Astra, Sol, Luna или 6.1 Sol
В семейство GPT-6 входят Astra, Sol, Luna и более новая GPT-6.1 Sol. Для сложной работы в Codex, ChatGPT Work или через API стоит сначала проверить 6.1 Sol. Для массовой классификации и извлечения данных — Luna; для наиболее трудных научных, аналитических и профессиональных задач — Astra. Название «GPT-6» в обычном чате ChatGPT имеет отдельное соответствие моделям и не означает автоматически 6.1 Sol.
В сентябре 2026 года OpenAI выпустила Astra 3 сентября, Sol и Luna — 22 сентября, а 6.1 Sol — 29 сентября. Линейка охватывает разные задачи и бюджеты. официальная хронология выпусков
По сравнению с GPT-5.6 важнее всего выполнение сложной работы, вероятность успешного результата и стоимость. Опыт пользователей неоднозначен: одни высоко оценивают Astra в профессиональных задачах, другие недовольны кодом 6 Sol; низкая стоимость 6.1 Sol сопровождается жалобами на ожидание. Разобраться помогают официальные тесты, расчёты расходов и проверяемые обсуждения сообщества.
Источники проверены 16 октября 2026 года. Все цены указаны в долларах США. Официальные оценки, пользовательские тесты и рекомендации автора обозначены отдельно.
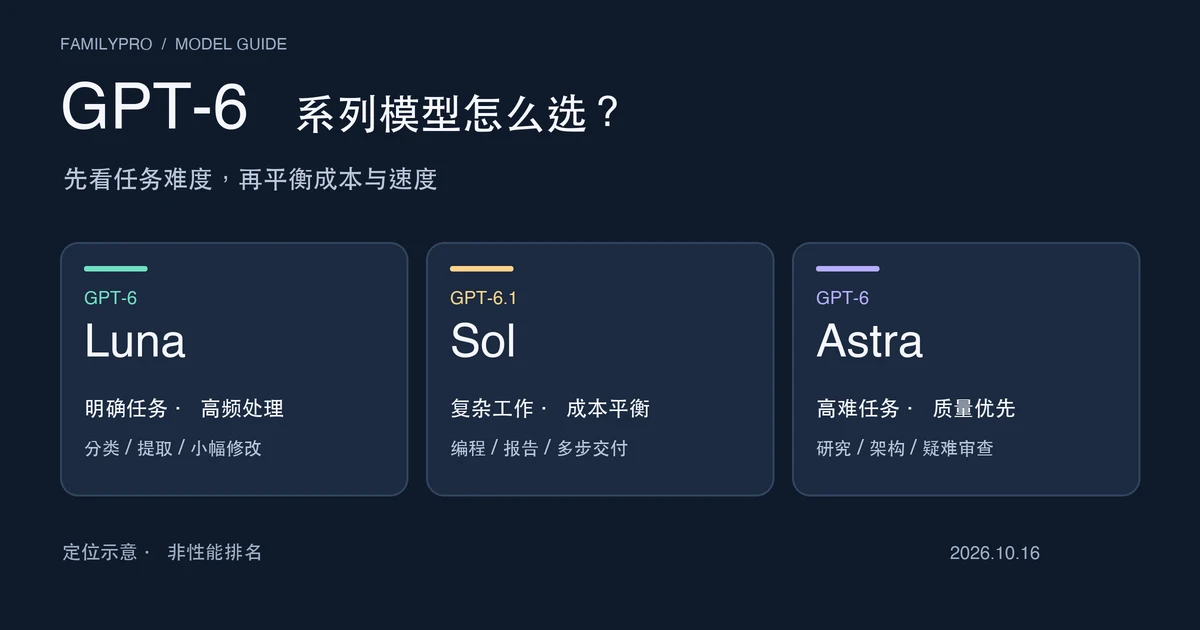
Редакционная схема позиционирования моделей, а не интерфейс продукта или результаты тестирования.
Быстрая навигация
- Какие модели входят в GPT-6
- Улучшения относительно GPT-5.6
- Чем 6.1 Sol отличается от 6 Sol
- Цены API и примеры расчёта
- Тарифы ChatGPT и доступ
- Выбор по типу задачи
- Отзывы и тест скорости
- FAQ
Какие модели входят в серию GPT-6?
В этой группе четыре отдельных модели, причём Sol представлена версиями 6 и 6.1.
| Модель | Позиционирование | Наиболее подходящая работа |
|---|---|---|
| GPT-6 Astra | Флагман с максимальными возможностями | Сложные рассуждения, исследования, программирование, профессиональные результаты |
| GPT-6 Sol | Первая сбалансированная модель | Программирование, инструменты, агентные процессы |
| GPT-6.1 Sol | Обновлённая сбалансированная модель | Сложная разработка, повседневная профессиональная работа, экономичные агенты |
| GPT-6 Luna | Лёгкая и эффективная модель | Массовая обработка, классификация, извлечение данных, частые автоматизации |
Astra ставит на первое место качество. 6.1 Sol стремится приблизиться к некоторым её возможностям при гораздо меньших затратах. Luna ориентирована на скорость и низкую цену. GPT-6 Sol по-прежнему доступна через API, но для нового проекта обычно разумно сначала оценить 6.1 Sol.
В семействе 5.6 были Sol, Terra и Luna. Официальной GPT-6 Terra сейчас нет: промежуточную позицию нового поколения фактически занимает 6.1 Sol. каталог моделей OpenAI
GPT-6 Astra: флагман
OpenAI позиционирует Astra как свою наиболее сильную универсальную модель для глубокой проработки и качественного выполнения сложной работы. Примеры — анализ больших репозиториев, сложные деловые отчёты, профессиональное ПО, научные рассуждения и длительные многошаговые действия на компьютере.
Акцент сделан на работе с инструментами и доведении процесса до завершения. Результат всё равно зависит от инструментов и разрешений приложения. Существенно более высокая стоимость делает Astra оправданной не во всех сценариях.
GPT-6 Sol: исходный баланс возможностей и цены
Sol переносит часть флагманских возможностей в более дешёвый сегмент для разработки, профессиональной работы и агентов. Стандартные цены API на вход и выход составляют по одной пятой от Astra.
Отзывы разделились. Некоторые разработчики, долго использовавшие 5.6 Sol, считают, что экономия сопровождается ухудшением полноты и стабильности выполнения сложных задач.
GPT-6.1 Sol: сложная работа с меньшими расходами
6.1 Sol вышла через неделю после 6 Sol. Заявленная цель — приблизиться к Astra в сложной работе при существенно меньшей стоимости. Основные улучшения касаются разработки ПО, понимания документов, управления компьютером и фактической точности.
В сообществе встречается название «Astra Lite», но официальной модели с таким именем нет. Цитируемые официальные материалы не раскрывают архитектурную связь; считать 6.1 Sol сжатой версией Astra на этом основании нельзя.
GPT-6 Luna: экономичное выполнение понятных задач
Luna — самая дешёвая и наиболее ориентированная на скорость модель серии. Она подходит для классификации обращений, извлечения структурированных данных, простых изменений кода, фильтрации информации и обычной автоматизации.
Чтобы отличить запрос возврата от жалобы, обычно не нужны передовые математические способности. Частые задачи с ясными границами — основная область применения Luna.
GPT-6 против GPT-5.6: что стало лучше?
Официальные результаты указывают прежде всего на прогресс в сложной работе и использовании инструментов. Улучшения не одинаковы во всех задачах.
1. Программирование: прирост зависит от теста
Ниже приведены данные из отчёта о выпуске Astra. Это срез конкретного отчёта с лучшими результатами при разных уровнях рассуждения, а не сравнение на одинаковой настройке. Оценка проводилась в исследовательской среде или через API; поведение промышленной версии ChatGPT может отличаться. Мы не повторяли эти тесты независимо.
| Тест | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4.0 | 37.3% | 57.9% |
| DeepSWE v1.1 | 72.7% | 74.1% |
| FrontierCode 1.1 Main (баллы) | 47.5 | 53.3 |
| Миграция баз данных (внутренний тест) | 42.7% | 63.9% |
В Terminal-Bench Astra прибавляет 20,6 процентного пункта, в DeepSWE — лишь 1,4. GPT-6 не намного сильнее 5.6 в абсолютно любой работе с кодом. Разница оправдывает отдельную проверку сложных терминальных задач, но двух показателей недостаточно для классификации всех задач программирования по величине прогресса.
Для разработчика понимание репозитория, запуск тестов и готовый к интеграции код могут быть ценнее скорости генерации текста.
2. Computer Use: от ответов к управлению компьютером
Управление компьютером — одно из ключевых направлений улучшений. Таблица использует условия отчёта о выпуске Astra: офлайн-набор OSWorld v2026.08.08, ScreenSpot-Pro без инструментов.
| Тест | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| OSWorld 2.0 (офлайн, частичные баллы) | 65.7% | 72.6% |
| ScreenSpot-Pro | 76.9% | 92.7% |
| AutomationBench | 18.1% | 41.4% |
OSWorld оценивает реальные компьютерные задачи; ScreenSpot-Pro — поиск элементов визуального интерфейса; AutomationBench — преимущественно бизнес-процессы с несколькими инструментами.
В официальной симуляции задержек OSWorld 5.6 Sol требовалось около 75 минут на задачу при оценке 65,7%, Astra — около 40 минут при 72,6%. Здесь начисляются частичные баллы: проценты нельзя понимать как долю полностью выполненных задач. При росте оценки моделируемое время сокращается примерно на 47%. Это результат определённой среды, а не обещание аналогичного ускорения любой реальной работы.
3. Исследования: более сложные рассуждения
В Terminal-Bench Science 0.1 у 5.6 Sol 22,4%, у Astra — 64,6%. В FrontierMath Tier 4 (v2) результаты составляют 83,0% и 97,6% соответственно.
Это данные отчёта о выпуске Astra; последующие отчёты могут содержать обновлённые значения. Они показывают прогресс в названных тестах, но не позволяют вычислить улучшение для всей науки. Высокие баллы не заменяют независимой проверки методов, данных, экспериментов и выводов.
4. Фактическая точность и границы действий
OpenAI сообщает, что в специально подготовленной сложной оценке фактологичности 6 Sol допускает примерно вдвое меньше фактических ошибок, чем предыдущее поколение. 6.1 Sol улучшает результат ещё сильнее: на низком уровне рассуждения доля ответов с ошибками снижается с 11,4% до 7,7%.
Это 3,7 процентного пункта, или около 32% относительно исходного значения. В обоих анонсах подчёркивается: примеры взяты из трудных разговоров, где пользователи уже отмечали ошибки. Они не отражают повседневный уровень ошибок. официальная оценка 6.1 Sol
Astra также специально обучали точнее соблюдать разрешённые границы, реже выполнять несанкционированные дополнительные действия, вводить в заблуждение отчётами о выполнении и отклоняться от цели. Агент с доступом к файлам, браузеру и внешним системам должен понимать не только что он может, но и что не вправе делать самостоятельно.
5. Контекст в длительной работе
Для Astra в Codex OpenAI представила экспериментальный механизм сохранения контекста. Обычные краткие пересказы длинных разговоров могут терять важные детали. Описанный подход позволяет хранить рабочие заметки и извлекать содержимое прошлых окон контекста, помогая при длительной отладке и крупных рефакторингах.
Доступность и порядок включения нужно уточнять в текущей документации клиента: анонс не означает, что это стандартное поведение во всех средах. Улучшено и кеширование запросов. Повторное использование репозиториев, деловых материалов и системных инструкций может снижать расходы корпоративных агентов. отчёт о выпуске Astra · анонс Sol и Luna
Что такое GPT-6.1 Sol и чем она отличается от 6 Sol?
Если Astra задаёт верхнюю планку возможностей, то 6.1 Sol представляет новую оптимизацию экономичности.
Некоторые результаты близки к Astra при цене в пять раз ниже
В отдельных тестах разработки, документов и работы с компьютером 6.1 Sol приближается к Astra при значительно меньших затратах на задачу. По данным OpenAI, в DeepSWE v1.1 она превосходит лучший результат 6 Sol на 6,4 процентного пункта при меньшей интенсивности рассуждений и стоимости. Сопоставимого с Astra результата удаётся достичь примерно за пятую часть расходов на задачу.
В офлайн-OSWorld 2.0 при максимальном рассуждении (Max) отставание от Astra укладывается в 2,1 процентного пункта, а стоимость задачи составляет около одной седьмой. Это условия отдельных тестов, не постоянные коэффициенты для любой работы. Самые сложные исследования OpenAI по-прежнему рекомендует поручать Astra. официальная оценка 6.1 Sol
Чтение кеша вдвое дешевле, чем у 6 Sol
Стандартные цены совпадают: $2 за миллион входных токенов и $10 за миллион выходных. Меняется чтение кеша: с $0.20 у 6 Sol до $0.10 у 6.1 Sol.
На разовом небольшом вопросе это может быть незаметно. Однако агент разработки многократно читает код, определения инструментов и историю работы. При попаданиях в кеш экономия накапливается. Если на сложной задаче дополнительно используется меньше токенов, фактическая стоимость может заметно снизиться.
Низкая цена не гарантирует малую задержку
Многим нужен не самый мощный модельный вызов каждый раз, а надёжная обработка большинства задач без быстрого исчерпания бюджета. На это и рассчитана 6.1 Sol. Дешевле не означает быстрее. Скорость зависит от режима обслуживания, рассуждений и нагрузки; некоторые разработчики находят её существенно медленнее 5.6 Sol.
Если собственные тесты подтверждают долгие ожидания, модель можно применять к сложным фоновым задачам. Для интерактивных сценариев задержку следует измерять отдельно. У 6.1 Sol нет уровней none и minimal, минимум — low. Для простых задач стоит сравнить Luna с поддержкой none. Вызовы инструментов с 6.1 Sol требуют Responses API: одной замены идентификатора модели в старом приложении недостаточно для миграции. документация API 6.1 Sol
Цены GPT-6 API и расчёт расходов
Ниже официальные тарифы Standard в долларах за миллион токенов для обычных текстовых запросов не более 272K входных токенов.
| Модель | Вход | Кешированный вход | Выход |
|---|---|---|---|
| GPT-5.6 Sol | $4.00 | $0.40 | $20.00 |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 |
| GPT-6 Sol | $2.00 | $0.20 | $10.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
Обычные вход и выход Astra стоят в 2,5 раза дороже 5.6 Sol. У 6 Sol и 6.1 Sol они вдвое дешевле 5.6 Sol. При одинаковом обычном расходе токенов Luna стоит в сто раз дешевле Astra — её стоит первой проверить для большого числа легко проверяемых задач.
Для 5.6 Sol сейчас действует акционная цена: OpenAI обещает её как минимум до 21 ноября 2026 года. После этой даты необходима новая проверка. примечания к цене 5.6 Sol
Цена токена и полная стоимость завершённой задачи — разные показатели. Более сильная модель может использовать меньше токенов, инструментов и повторных попыток.
Пример: автоматизированная поддержка
Предположим, система обрабатывает 1 000 запросов в месяц. Каждый использует в среднем 2 000 входных токенов и 500 оплачиваемых выходных, включая токены рассуждения. Итого два миллиона входных и 500 000 выходных токенов.
Это расчёт при фиксированном расходе, не измеренная средняя стоимость. Без кеша, инструментов, повторов и дополнительных услуг получится:
| Модель | Теоретическая стоимость API в месяц |
|---|---|
| GPT-6 Astra | $45.00 |
| GPT-6.1 Sol | $9.00 |
| GPT-6 Luna | $0.45 |
Для 6.1 Sol: 2 миллиона ÷ 1 миллион × $2 плюс 500 000 ÷ 1 миллион × $10 = $9. В этом примере Astra дороже Luna в 100 раз.
Внутренние токены рассуждения оплачиваются как выходные. Если «500 токенов» — только видимый ответ, расход на размышления нужно добавить. оплата токенов рассуждения
Для классификации обращений, извлечения номера заказа и выдачи JSON может хватить Luna. Сложные договорные споры, анализ доказательств по жалобе и многошаговые решения могут оправдать более сильную модель, если она сокращает ручную обработку ошибок.
Другие правила оплаты
Основные модели GPT-6 поддерживают около 1,05 миллиона токенов контекста и до 128K выходных. Эта ёмкость уже была у 5.6 Sol. При входе свыше 272K токенов ко всему запросу применяется длинноконтекстный тариф: цены входа и операций, связанных с кешем, удваиваются, выхода — умножаются на 1,5.
Чтение и запись кеша — разные операции. Чтение у 6.1 Sol стоит $0.10 за миллион токенов, стандартная запись — $2.50.
Есть и классы обработки:
- Batch / Flex: обычно на 50% дешевле Standard с компромиссами по пропускной способности, очереди или задержке.
- Fast: обычно вдвое дороже Standard за более быстрое обслуживание.
- Ultrafast: API 6.1 Sol за шестикратную стандартную цену для особенно чувствительных ко времени процессов.
Поддержку конкретного класса нужно проверять для модели. Ценовой множитель не является множителем скорости; поддерживаемая региональная обработка может дополнительно стоить 10%. полный прайс-лист API
Тарифы ChatGPT и доступ к GPT-6
ChatGPT использует подписки и квоты, API оплачивается преимущественно по токенам и классу обслуживания. Plus не включает автоматически $20 ежемесячного API-баланса.
В таблице официальные месячные цены в долларах. Регион, налоги и фактический расчёт аккаунта могут отличаться. Обычный Chat и Work/Codex — разные точки доступа: права в одной не доказывают доступ в другой.
| Тариф | Цена в месяц | Доступ, связанный с GPT-6 |
|---|---|---|
| Free | Бесплатно | Обычный Chat постепенно переводится на 5.6 Luna; отдельное развёртывание 6 Luna в Codex для компьютера |
| Go | $8 на официальной долларовой странице; местную цену проверять отдельно | 5.6 Luna в Chat; отдельное развёртывание 6 Luna в Codex для компьютера |
| Plus | $20 | GPT-6 Sol в Chat; Astra, 6.1 Sol и другие в Work/Codex |
| Pro 100 | $100 | GPT-6 Pro и повышенные рабочие квоты |
| Pro 200 | $200 | Более высокие квоты GPT-6 Pro, Work и Codex |
| Pro 500 | $500 | Максимальные квоты, включая доступ к Ultrafast |
Доступ Free и Go к 6 Luna в настольном Codex зависит от этапа развёртывания. Основания: описание моделей Chat, цены Work/Codex и описание тарифов Pro. Enterprise и Education используют отдельные правила доступа и квот.
Какая модель скрывается за GPT-6 в чате?
При выборе GPT-6 в подходящем платном тарифе Chat действует следующее соответствие:
| Уровень рассуждения | Фактическая модель |
|---|---|
| Instant | GPT-6 Sol |
| Medium | GPT-6 Sol |
| High | GPT-6 Sol |
| Extra High | GPT-6 Sol |
| Pro | GPT-6 Pro на базе GPT-6 Astra |
Plus обычно предоставляет Instant, Medium и High, но не Extra High и Pro в чате. Более высокие тарифы дают дополнительные уровни; ориентироваться нужно на интерфейс аккаунта.
6.1 Sol сейчас не является отдельно выбираемой моделью обычного Chat. Она предназначена прежде всего для Work, Codex и API. Отсутствие в списке чата ничего не говорит о доступе через Work или Codex. У GPT-6 Pro отдельная квота: подписка Pro не означает безлимитную Astra.
Ultrafast в Pro 500 — не бесплатное ускорение: включённая квота расходуется в восемь раз быстрее стандартного режима соответствующей модели. После её исчерпания при использовании Credits действует шестикратная стандартная Credit-ставка.
Перед повышением тарифа определите, что нужно: больше задач, более сильная модель или меньшая задержка. Подробнее: квоты и сброс Codex и сравнение ChatGPT Go и Plus. описание моделей Chat · описание тарифов Pro
Как выбрать GPT-6 под конкретную задачу?
Ориентируйтесь на сложность и цену ошибки. Таблица опирается на официальное руководство по выбору модели и служит отправной точкой тестирования, не гарантией. В обычном Chat используются уровни интерфейса; диапазоны настроек Work/Codex и API нужно смотреть отдельно.
| Задача | Модель для первого теста | Рассуждение |
|---|---|---|
| Классификация, метки, извлечение данных | GPT-6 Luna | None / Low |
| Частые обращения поддержки, простой текст | GPT-6 Luna | Low / Medium |
| Повседневное общение в ChatGPT | GPT-6 Sol | Instant |
| Длинные статьи, обычный анализ, обсуждение планов | GPT-6 Sol | Medium / High |
| Обычная разработка, исправление ошибок | GPT-6.1 Sol | Medium |
| Рефакторинг нескольких файлов, сложное ревью | GPT-6.1 Sol | High / XHigh |
| Большие проекты, сложные действия на компьютере | GPT-6 Astra | Начать с Medium, при необходимости High / Max |
| Сложная наука и профессиональные рассуждения | GPT-6 Astra | Сравнить Medium с High / Max |
| Плановая массовая автоматизация | GPT-6 Luna, при необходимости Sol | Low / Medium |
Повышение уровня рассуждения может увеличивать число внутренних проверок, расход токенов и время. Для простых чётких задач оно не обязательно улучшает ответ и может снижать эффективность.
Стратегия 1: начинать дёшево и повышать уровень по необходимости
Многоуровневая маршрутизация отдаёт Luna обычные задачи. Неудачные проверки правил, противоречивые сведения и заведомо многошаговые проблемы передаются 6.1 Sol. Решение должно учитывать бизнес-правила, проверку выходов и выборочную приёмку, а не только заявленную моделью уверенность. Astra подключается для действительно сложных случаев с дорогими ошибками.
Например, поддержка классифицирует обращения через Luna, анализирует договорные споры через Sol, а небольшое число рискованных случаев передаёт Astra для помощи в проверке. Окончательное решение принимает человек. Это часто экономичнее флагмана для каждого запроса.
Стратегия 2: измерять стоимость успешного результата
Полезная метрика — полные затраты на успешно выполненную задачу. Упрощённо:
Полная стоимость = вызовы модели + инструменты + повторные попытки + ручные исправления.
Если дешёвой модели нужны пять попыток, а Astra одна, высокая цена токена не обязательно означает больший итоговый счёт. Для кода учитываются пройденные тесты, готовность к интеграции, разумный объём изменений и время ревью.
Стратегия 3: выполнять длительную работу асинхронно
Сканирование больших репозиториев, недельные отчёты, обработку документов и долгий анализ можно поручать 6.1 Sol в фоне или параллельно, если немедленный ответ не нужен. Независимые фоновые задачи сокращают ожидание человека, но не автоматически общий счёт.
Для интерактивного продукта могут лучше подойти Luna, более низкое рассуждение или ускоренный класс обслуживания.
Стратегия 4: повторно использовать кешируемый контекст
Стабильные системные инструкции, определения инструментов, описания репозитория и другие повторяющиеся префиксы помогают переиспользовать статический контекст. Чтение кеша 6.1 Sol стоит $0.10 за миллион токенов. Попадания нужно проверять по реальным данным: повторная отправка текста не гарантирует кешированную тарификацию всего содержимого.
На длинных многошаговых процессах хорошая доля попаданий даёт заметную суммарную экономию. Кеш не заменяет правильного управления контекстом: устаревшие и ненужные сведения всё равно следует удалять.
Отзывы о GPT-6: качество кода, стоимость и скорость
Следующие примеры можно проследить до исходных публикаций, прежде всего Reddit и Hacker News. Это не случайная выборка и не мнение всего интернета. Выделяются три типа опыта: признание Astra при недовольстве расходом, предпочтение 5.6 вместо 6 Sol и готовность ждать 6.1 Sol ради экономии.
1. Astra: сильна в профессиональной работе, но не везде лучше
Пользователь imadade в r/singularity пишет, что Astra справляется с проблемами, для которых другим моделям требовались многократные подсказки, и задаёт вопросы главным образом при действительно недостающей информации. Он ценит её суждения в деловых и теоретических вопросах и более краткое общение. Reddit: первые впечатления от Astra
На Hacker News один участник при одинаковых запросах получает от Astra более релевантные источники и качественные учебные материалы, чем от 5.6 Sol. Другой хвалит синтез информации и естественность языка, но считает цену высокой, а квоты легко исчерпаемыми. Есть и сообщения об автоматизации рабочего стола, где Astra останавливается и требует повторно просить продолжить.
Рост возможностей не гарантирует улучшения опыта всех пользователей: важны планирование, запросы, окружение и управление квотой. Hacker News: отзывы об Astra
2. Sol: почему некоторые предпочитают 5.6
Jarr11 в r/OpenAI считает 6 Sol менее тщательной и полной в сложных задачах по сравнению с 5.6 Sol. Для него остаётся пробел между недостаточно сильной Sol и слишком дорогой Astra; некоторые комментаторы возвращаются к 5.6. Reddit: заменяет ли 6 Sol модель 5.6?
Это пользовательский опыт, а не полноценное контролируемое исследование. Уровень рассуждения, разрешения инструментов и среда способны существенно менять результаты. Улучшение официальных тестов не гарантирует равный выигрыш каждого прежнего рабочего процесса.
3. 6.1 Sol: 24 реальные задачи разработки при меньших расходах
bisonbear2 сравнил 6 Sol и 6.1 Sol на 24 уже принятых изменениях репозитория Go/TypeScript. Каждая модель выполняла каждую задачу один раз с Medium.
| Результат прямого сравнения | GPT-6.1 Sol |
|---|---|
| Лучше GPT-6 Sol | 9 задач |
| Ничья | 10 задач |
| Хуже GPT-6 Sol | 5 задач |
В общей оценке у 6.1 Sol небольшое преимущество. Пять проигрышей — относительные сравнения, не пять проваленных заданий; вычислять из них успешность нельзя. Типичная стоимость составляет примерно половину: помимо дешёвого кеша модель часто использует меньше токенов.
Но изменения кода получаются шире, что может потребовать большего ручного ревью. Разница по времени невелика; заметно быстрее 6.1 Sol не стала. Метод описан, однако проверены лишь один репозиторий, 24 задачи и одна попытка на модель и задачу. Общая оценка включает модель-судью; автор одновременно разрабатывает инструмент оценки Stet. Это ограничивает переносимость выводов. Reddit: сравнение на 24 задачах разработки
4. Насколько быстра 6.1 Sol? Один пользовательский тест
Hot_Season8992 опубликовал в r/codex измерения с уровнем XHigh у всех моделей.
| Модель | Скорость Normal | Скорость Fast |
|---|---|---|
| GPT-5.6 Sol | 102.6 Token/s | 168.1 Token/s |
| GPT-6 Sol | 77.0 Token/s | 117.4 Token/s |
| GPT-6 Astra | 44.4 Token/s | 65.4 Token/s |
| GPT-6.1 Sol | 22.3 Token/s | 64.2 Token/s |
| GPT-6 Luna | 184.7 Token/s | 188.5 Token/s |
В этом тесте Normal у 6.1 Sol выдаёт примерно пятую часть токенов в секунду относительно 5.6 Sol. Fast заметно ускоряет 6.1 Sol, но остаётся медленнее 5.6 Sol Fast. Reddit: скорость 6.1 Sol
Это не официальная гарантия пропускной способности, а измерения одного человека в конкретное время и окружении. На результаты влияют аккаунт, нагрузка и тип запроса. Кроме того, Token/s не равняется полной длительности задачи: меньше инструментальных вызовов и повторов может обеспечить более ранний результат даже при медленной генерации.
На Hacker News conception считает ожидание слишком дорогим и предлагает часть работы переносить на быстрые модели. Другие разработчики находят баланс скорости и качества приемлемым без максимального уровня рассуждения. Hacker News: обсуждение задержек
5. Качество по-прежнему вызывает противоположные оценки
Upper-Animator-5067 попросил 6.1 Sol с Medium создать мини-игру о джунглях по заданному процессу разработки. По его отчёту, важных функций не хватало, нормально играть было нельзя, а повторные просьбы исправить проблемы не привели к ожидаемому результату. Reddit: неудачный тест создания игры
Impossible-Sand5012, напротив, сообщает о надёжных результатах и низком расходе квоты при нескольких параллельных Max-задачах. Это личный отзыв без полных журналов использования для сопоставимого анализа. Reddit: медленно, но эффективно
Долгосрочная поддержка большого репозитория, создание целой игры с нуля и интерактивное программирование предъявляют разные требования к «хорошей модели».
Какие выводы допустимы?
Часть пользователей подтверждает высокую планку Astra, особенно в профессиональной работе и сложных операциях, но не превосходство в каждой задаче над 5.6. Жалобы на 6 Sol показывают, что низкая цена не компенсирует проблемы некоторых процессов, а не доказывают всеобщий регресс.
В отчёте на 24 задачах главный выигрыш 6.1 Sol — стоимость; отдельный тест скорости напоминает проверять задержку для интерактивной работы. Социальные сети заметно смещены: особенно хорошие и плохие впечатления публикуют чаще, а уровень рассуждения, версию, нагрузку и инструменты часто не контролируют. Обсуждения помогают найти риски для проверки, но не заменяют собственную оценку на реальной нагрузке.
Как разработчикам оценивать GPT-6 на практике?
Перед внедрением полезно собрать небольшой набор реальных задач; сложный универсальный бенчмарк не обязателен. Например, отобрать 30–50 недавних заданий с простыми, средними и трудными случаями. Это стартовая рекомендация, не гарантия статистической репрезентативности.
Сравните 6.1 Sol, Luna и Astra при одинаковых описаниях, данных и разрешениях инструментов. Записывайте как минимум:
- Успешность: действительно ли выполнена задача и соблюдены требования.
- Полную стоимость: вход, выход, кеш, инструменты и повторы.
- Время: от отправки до пригодного результата, не только Token/s.
- Участие человека: напоминания, исправления и устранение ошибок модели.
Выбирать следует по бизнес-целям, а не месту в рейтинге. Для сложной работы разумно начать с 6.1 Sol Medium, затем сравнить Low и High по расходу и результативности. Для частых стандартных функций сначала проверить Luna. Astra добавлять, когда реальные тесты подтверждают потребность в большей мощности. Так проще устойчиво сочетать качество, скорость и бюджет.
FAQ о моделях GPT-6
Какая модель GPT-6 самая мощная?
OpenAI позиционирует Astra для наиболее трудной работы. Выбор всё равно зависит от успешности, времени и полного расхода. Для обычной сложной разработки сначала проверьте 6.1 Sol, для извлечения и классификации — Luna. Флагман нужен не каждому запросу.
GPT-6.1 Sol дешевле GPT-6 Sol?
Обычные вход и выход стоят одинаково: $2 и $10 за миллион токенов. Чтение кеша снижается с $0.20 до $0.10. Итог зависит также от рассуждений, попаданий в кеш, инструментов и переделок; универсального снижения вдвое нет.
Доступна ли GPT-6.1 Sol в ChatGPT Plus?
Текущее официальное описание включает 6.1 Sol в ChatGPT Work и Codex для Plus. GPT-6 в обычном Chat выбирается по другой схеме. Фактический доступ зависит от развёртывания, версии клиента и прав аккаунта.
GPT-6.1 Sol всегда медленнее 5.6 Sol?
Цитируемый пользовательский тест обнаружил меньшую скорость Token/s в своей среде, но это не правило для всех запросов. Сравнивать нужно полное время одинаковых задач при одинаковом рассуждении и режиме обслуживания.
Нужно ли полностью переходить с GPT-5.6 на GPT-6?
Сначала сохраните 5.6 как контрольный вариант и сравните новые модели на тех же заданиях. Переходите, когда улучшение качества, расходов или ожидания оправдывает миграцию. Одно приложение может распределять разные задачи между Luna, Sol и Astra.
Источники
- официальная хронология выпусков
- каталог моделей OpenAI
- отчёт о выпуске Astra
- официальная оценка 6.1 Sol
- анонс Sol и Luna
- документация API 6.1 Sol
- примечания к цене 5.6 Sol
- оплата токенов рассуждения
- полный прайс-лист API
- описание моделей Chat
- цены Work/Codex
- описание тарифов Pro
- официальное руководство по выбору модели
- Reddit: первые впечатления от Astra
- Hacker News: отзывы об Astra
- Reddit: заменяет ли 6 Sol модель 5.6?
- Reddit: сравнение на 24 задачах разработки
- Reddit: скорость 6.1 Sol
- Hacker News: обсуждение задержек
- Reddit: неудачный тест создания игры
- Reddit: медленно, но эффективно
Официальные данные и цены проверены 16 октября 2026 года. Пользовательские показатели приводятся по сообщениям их авторов; мы не повторяли эти тесты независимо.